Bất kỳ Data Engineer hay Backend Developer nào từng chạy các dự án thu thập dữ liệu (web scraping) đều thấu hiểu một kịch bản đau tim quen thuộc: Script chạy mượt mà trên môi trường local với vài trăm URL, nhưng ngay khi đẩy lên production để scale lên hàng triệu request, pipeline lập tức vỡ vụn. Các dashboard giám sát ngập tràn cảnh báo lỗi HTTP 403 Forbidden, 429 Too Many Requests và tình trạng connection timeout.
Thực tế, khi phân tích đối thủ trên các sàn thương mại điện tử, rào cản đáng kể không nằm ở việc viết logic bóc tách HTML, mà nằm ở tầng hạ tầng mạng. Đây là lúc việc ứng dụng Proxy dân cư trong Market Research trở thành thành phần quan trọng để xây dựng một luồng dữ liệu minh bạch, ổn định.
Tuy nhiên, với sự tiến hóa liên tục của các hệ thống chống bot (WAF) vào năm 2026, những kỹ thuật cũ kỹ như đổi User-Agent hay tự dựng Gateway thủ công đã không còn mang lại hiệu quả cao. Làm thế nào để cấu trúc một pipeline hiện đại, vượt qua các rào cản từ TLS Fingerprinting cho đến hiện tượng dội bom request (Thundering Herd)? Hãy cùng đi sâu vào kiến trúc thực chiến ngay sau đây.
Sự sụp đổ của hạ tầng thu thập dữ liệu truyền thống khi scale
Nhiều đội ngũ kỹ thuật khi mới bắt đầu thường chuộng sử dụng Datacenter IP vì chi phí băng thông hợp lý và độ trễ (latency) thấp. Tuy nhiên, khi áp dụng vào Market Research quy mô mở rộng, hạ tầng này nhanh chóng bộc lộ các điểm nghẽn nghiêm trọng.
Sai lệch dữ liệu (Data Bias) do định tuyến địa lý
Dữ liệu trên các nền tảng thương mại điện tử hiện đại không phải là dữ liệu tĩnh. Thuật toán của họ cá nhân hóa nội dung hiển thị dựa trên vị trí địa lý (geo-location) của IP truy cập. Nếu bạn dùng một Datacenter IP đặt tại Singapore để thu thập giá của một mặt hàng mục tiêu tại thị trường Mỹ, kết quả trả về sẽ sai lệch hoàn toàn về đơn vị tiền tệ, phí vận chuyển hoặc thậm chí là cảnh báo không hỗ trợ giao hàng.
Để đảm bảo tính toàn vẹn của dữ liệu, việc thu thập dữ liệu từ các vị trí khác nhau bằng IP hộ gia đình thật tại đúng khu vực mục tiêu là yêu cầu mang tính bắt buộc, giúp các báo cáo phân tích kinh doanh giữ nguyên giá trị thực tiễn.
Nỗi ám ảnh mang tên ASN và Rate-Limit
Các hệ thống tường lửa (WAF) thế hệ mới như Cloudflare, Akamai Bot Manager hay DataDome phân tích gói tin ở cấp độ sâu.
- Với lỗi 403 (Forbidden): WAF kiểm tra ASN (Autonomous System Number) ngay từ first packet. Vì Datacenter IP thuộc về các nhà cung cấp máy chủ cloud (như AWS, DigitalOcean), chúng mặc định bị xếp vào nhóm giao lượng rủi ro cao.
- Với lỗi 429 (Too Many Requests): Các IP thuộc dải Datacenter thường bị áp đặt ngưỡng giới hạn tần suất (Rate-Limit) rất khắt khe. Chỉ cần vài worker gửi request đồng loạt, giới hạn này bị phá vỡ, dẫn đến việc hệ thống gặp lỗi Rate Limit API trên diện rộng.
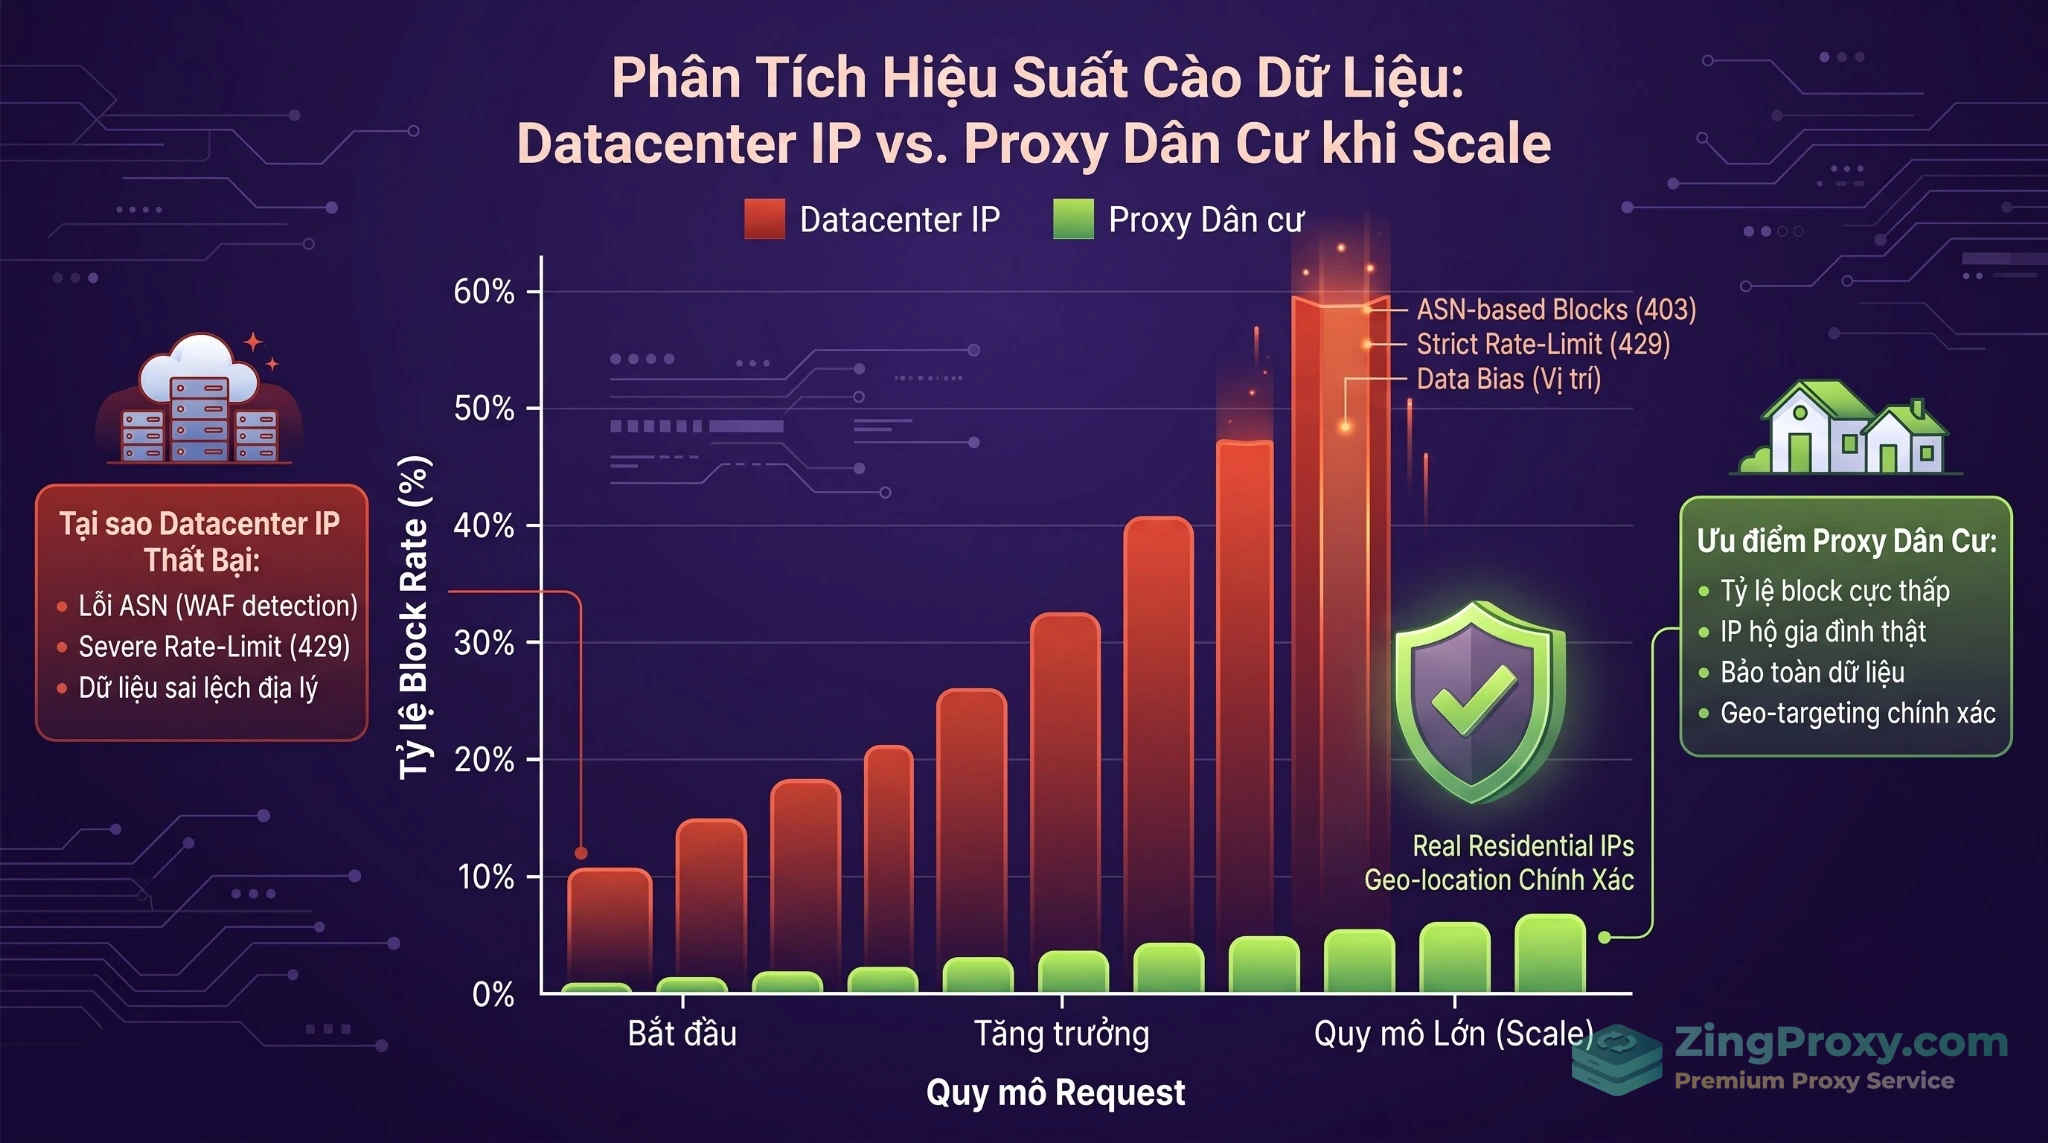
Tỷ lệ Block Rate của Proxy dân cư duy trì ở mức thấp, tối ưu hiệu suất thu thập dữ liệu trên quy mô mở rộng.
Vượt rào cản WAF: Kỹ thuật giả lập TLS Fingerprinting
Một sai lầm phổ biến của developer là cho rằng chỉ cần gắn IP Proxy dân cư trong Market Research và xoay vòng User-Agent ngẫu nhiên là đủ để hoạt động ổn định. Thực tế là, WAF chặn luồng kết nối trước cả khi HTTP Header được gửi đi.
Vấn đề của các HTTP Client tiêu chuẩn
Khi bạn tạo một kết nối HTTPS, bước đầu tiên là quá trình bắt tay TLS (TLS Handshake). Trong gói tin ClientHello, trình duyệt sẽ gửi đi một tập hợp các thông số mã hóa (cipher suites, extensions) gọi là JA3 hoặc JA4 Fingerprint.
Vấn đề là các thư viện lập trình mặc định như requests (Python) hay axios (Node.js) có cấu trúc gói tin TLS hoàn toàn khác biệt so với trình duyệt Chrome, Safari hay Firefox. Hệ thống WAF chỉ cần đối chiếu JA3 Fingerprint của bạn với danh sách chữ ký của bot là ngay lập tức thả lỗi 403 hoặc buộc giải CAPTCHA, bất kể bạn đang dùng IP chất lượng cao ra sao.
Giải pháp nâng cấp Worker
Để tận dụng giá trị của proxy dân cư, Worker của bạn phải biết cách đóng giả trình duyệt ở cấp độ mạng:
- Trong Python: Thay thế thư viện
requests bằng curl_cffi. Thư viện này bind trực tiếp với bộ mã nguồn của cURL giả lập trình duyệt, cho phép bạn dễ dàng gửi request với JA3 fingerprint tương đồng với Chrome 120+ hoặc Edge.
- Trong Node.js: Sử dụng thư viện
got-scraping. Nó được tinh chỉnh tự động để căn chỉnh thứ tự Header, HTTP/2 pseudo-headers và cipher suites sao cho khớp với các trình duyệt thông dụng.
- Trong môi trường phức tạp: Đối với các trang web yêu cầu render JavaScript nặng hoặc theo dõi chuyển động chuột, việc dùng các giải pháp Managed Browser (như Browserless) kết nối qua proxy dân cư là lựa chọn mang lại tỷ lệ thành công rất cao.
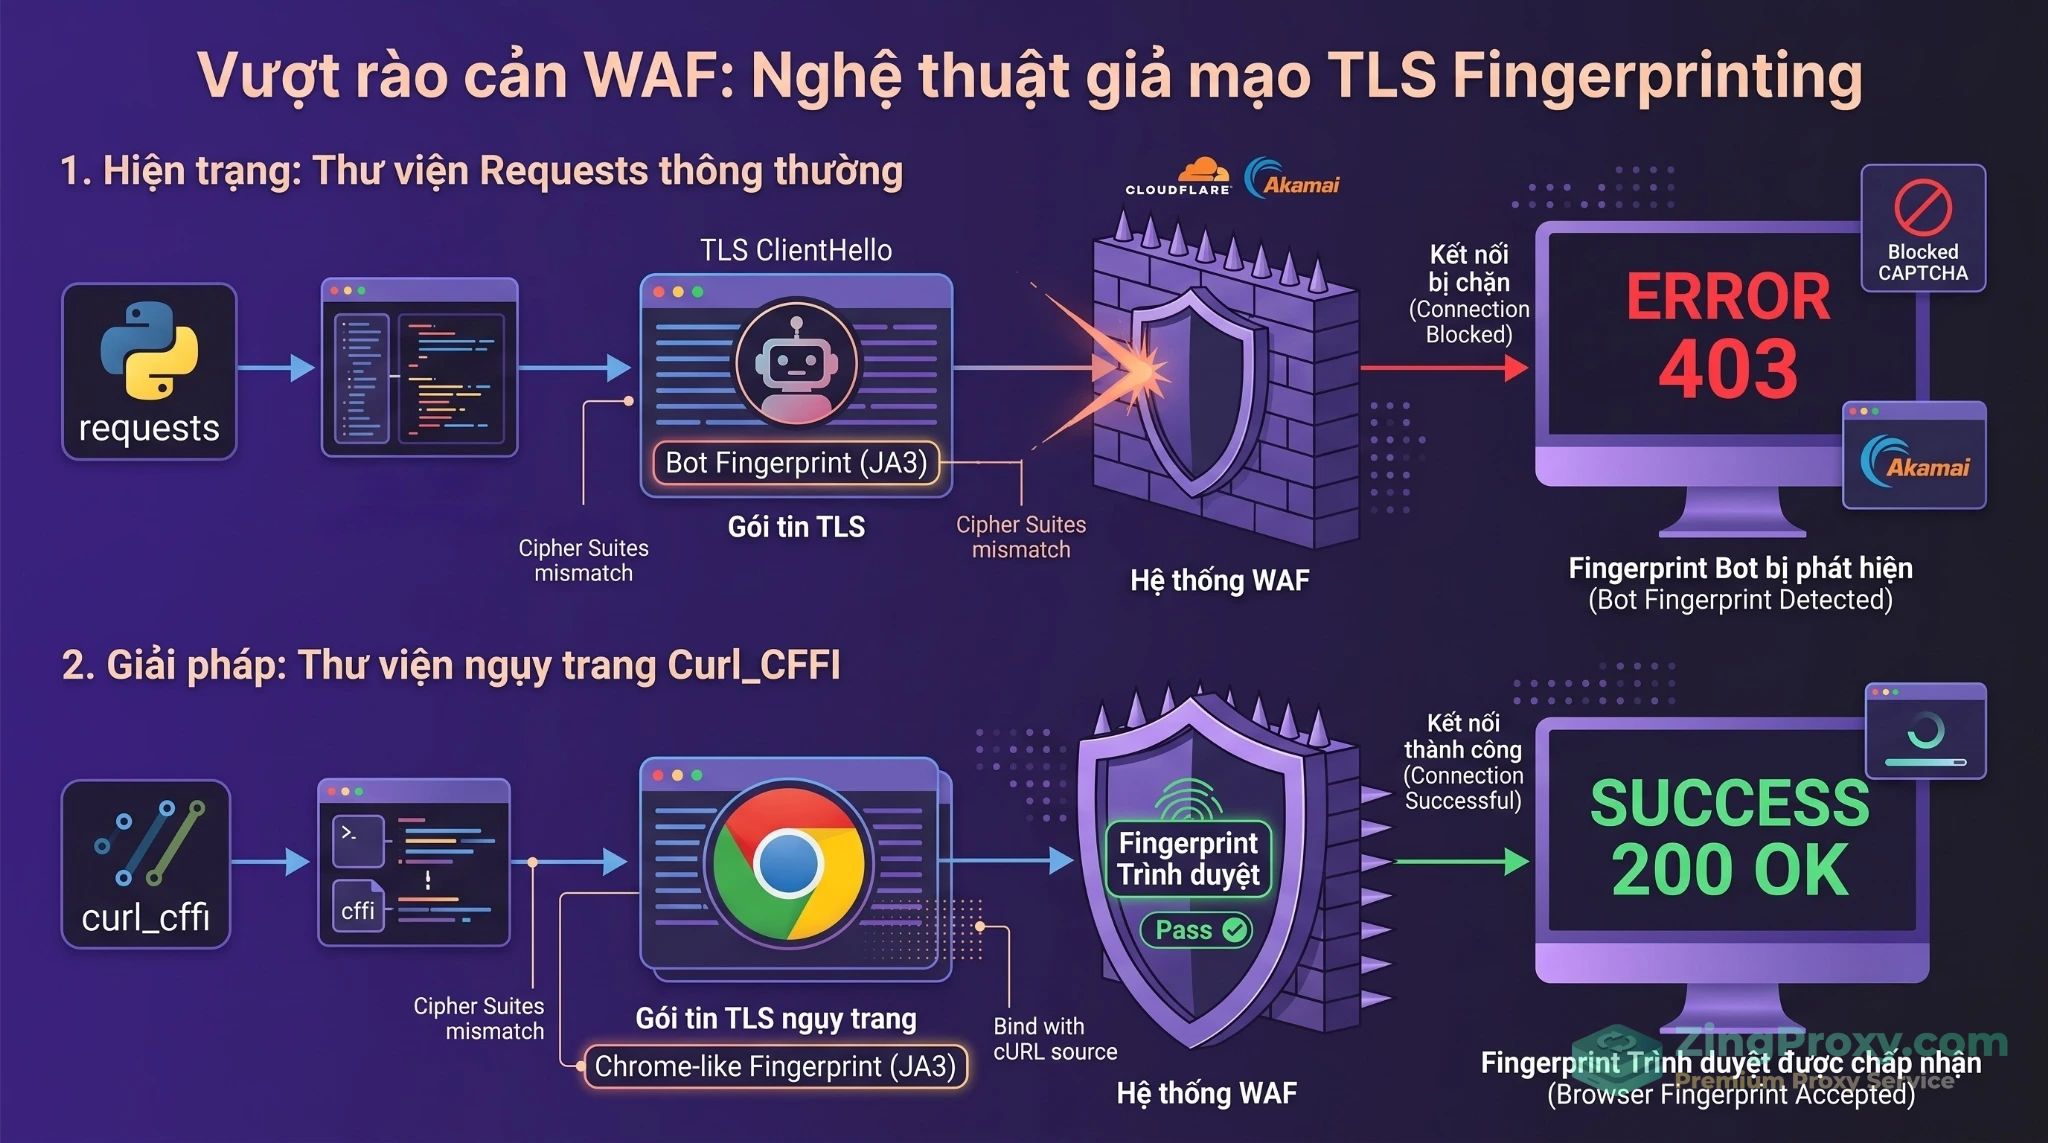
Can thiệp giả lập TLS Fingerprint ở cấp độ mạng giúp Worker vượt qua các hệ thống kiểm tra sâu như Cloudflare hay Akamai.
Kiến trúc Pipeline hiện đại: Từ bỏ DIY Gateway tiến lên Web Unlocker
Vào những năm trước, kiến trúc tiêu chuẩn mà các Data Engineer hướng tới là tự xây dựng một Proxy Gateway nội bộ bằng VPS chạy Nginx hoặc HAProxy. Worker sẽ gửi request đến Gateway, và Gateway sẽ dùng thuật toán Token Bucket để Rate-Limit, xoay vòng IP qua các dải proxy thô.
Tuy nhiên, cách làm Do It Yourself này đang trở thành gánh nặng vận hành. Việc phải bảo trì hạ tầng xoay IP, tự viết logic giải CAPTCHA, xử lý proxy mất kết nối (dead node) và tinh chỉnh thuật toán tránh rào cản liên tục khiến kỹ sư mất nhiều thời gian thay vì tập trung vào dữ liệu.
Chuyển dịch sang Scraping API / Web Unlocker
Thay vì mua proxy thô (raw proxy) và tự xây dựng lại luồng xử lý, các luồng Data Pipeline hiện đại tích hợp thẳng với các Web Unlocker hoặc Scraping API (từ các nhà cung cấp như ScraperAPI, Scrapfly, Bright Data, Oxylabs).
Bản chất của các dịch vụ này là một lớp Wrapper (bao bọc) mạnh mẽ nằm bên trên mạng lưới Proxy dân cư thu thập dữ liệu quy mô lớn.
- Single Endpoint: Worker của bạn chỉ cần gọi một API endpoint duy nhất.
- Ủy quyền vận hành: Hệ thống của nhà cung cấp sẽ tự động xử lý các tác vụ phức tạp: Tự động chọn location IP dân cư phù hợp, tự render JavaScript, tự động giả lập TLS/Browser fingerprint, và tự giải CAPTCHA.
- Chỉ trả tiền cho Success Rate: Điểm lợi ích đáng chú ý về mặt kinh tế là hệ thống chỉ tính phí khi trả về kết quả cấu trúc HTML hợp lệ, giúp doanh nghiệp tối ưu chi phí Cost Per Successful Record (Chi phí trên mỗi bản ghi thành công) mà không lãng phí băng thông cho các request thất bại.
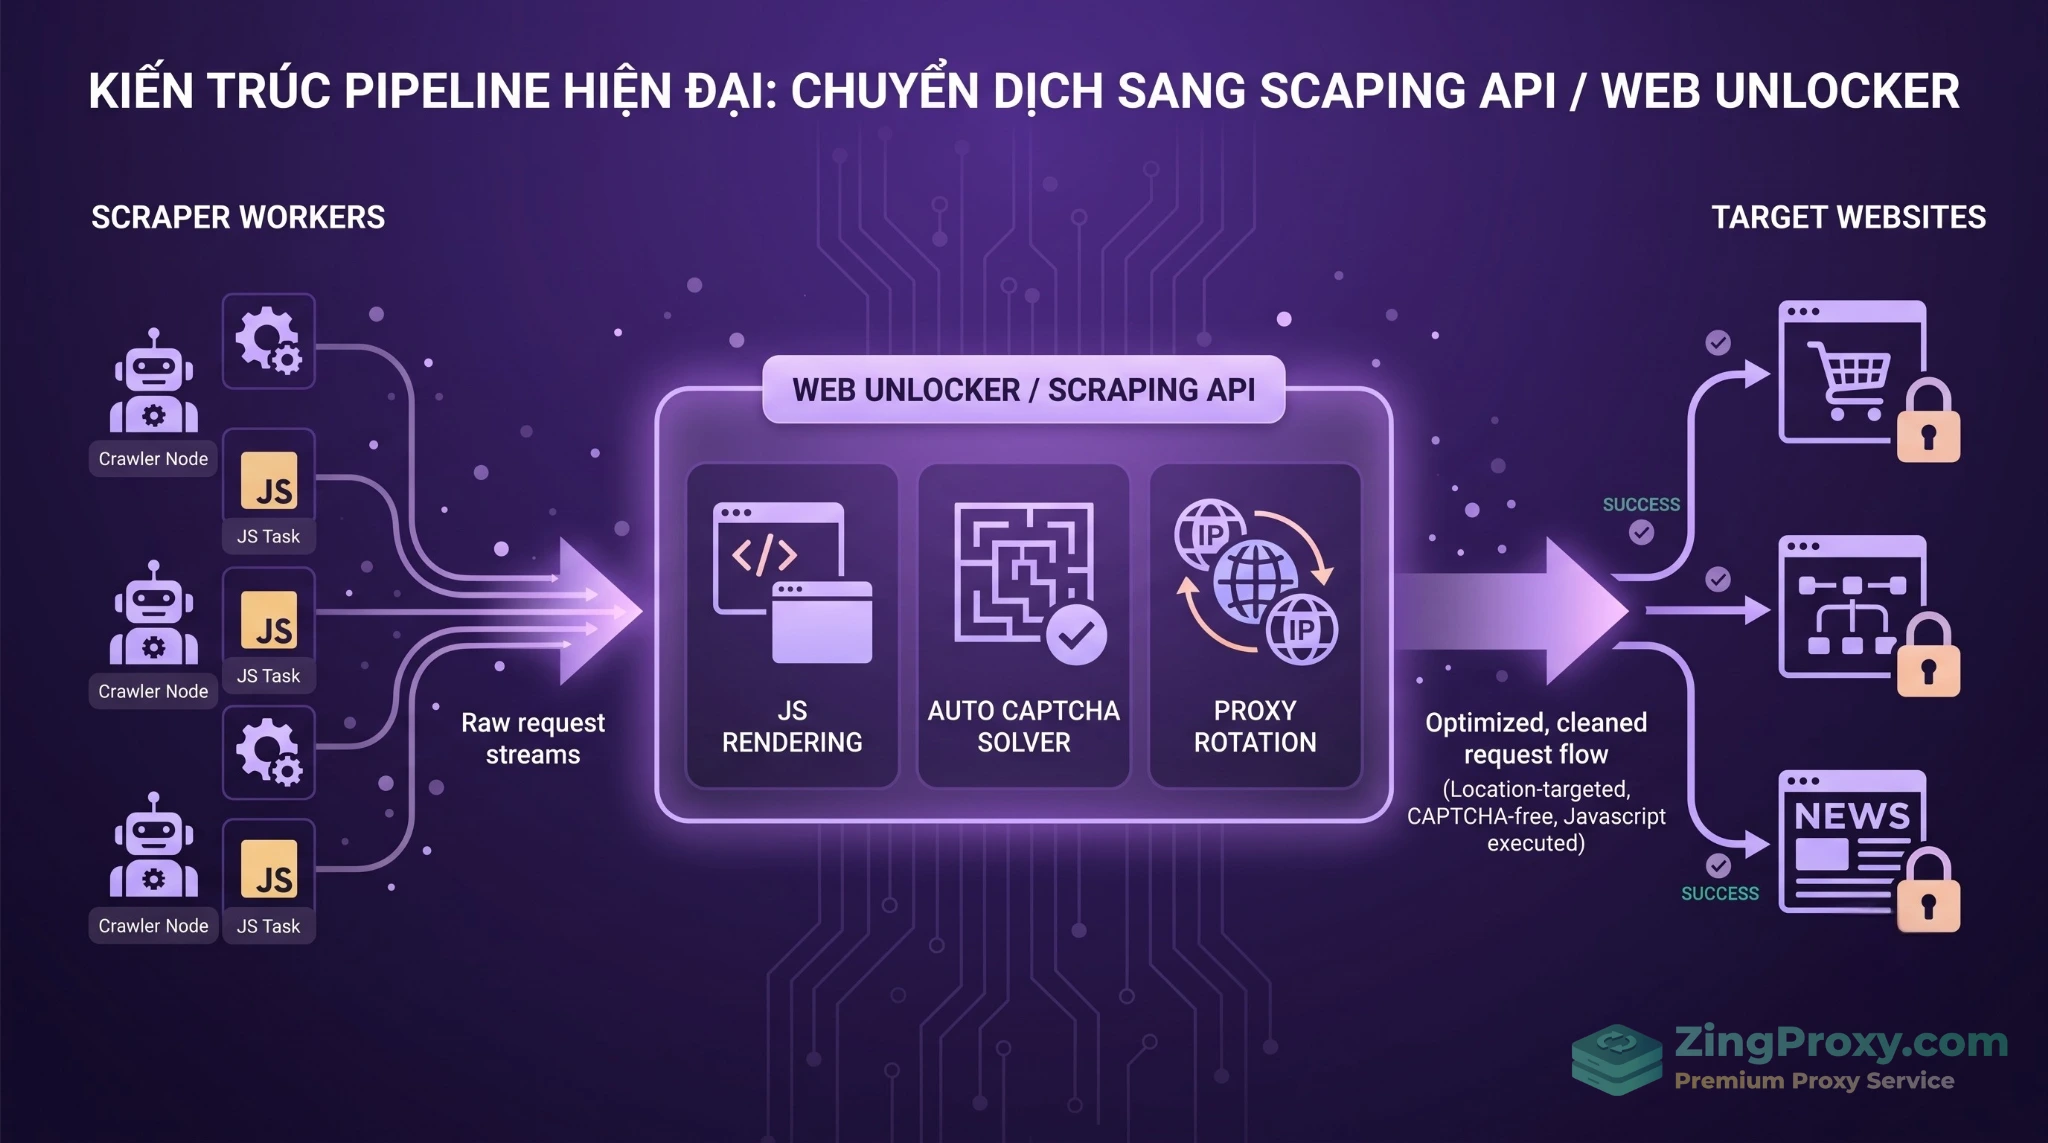
Mô hình tích hợp Web Unlocker giúp giải phóng kỹ sư khỏi gánh nặng bảo trì luồng proxy và thuật toán giải CAPTCHA thủ công.
Chiến lược cấu hình luồng thu thập nâng cao Success Rate
Dù bạn dùng Web Unlocker hay tự cấu hình Proxy Pool tự động, việc am hiểu cách thức định tuyến IP vẫn đóng vai trò quyết định trong thiết kế pipeline.
Định nghĩa chuẩn xác 4 cấp độ Success Rate
Đừng để hệ thống monitoring đánh lừa bạn bằng những mã HTTP 200 ảo (Soft Ban, trả về HTTP 200 nhưng nội dung là trang bắt nhập CAPTCHA). Thành công thực tế phải đi qua 4 tầng:
- Transport Success: Kết nối TCP/TLS thành công, không gặp timeout.
- HTTP Success: Nhận mã trạng thái 2xx hoặc 3xx.
- Parsing Success: HTML/JSON trả về chứa đúng các node/selector cần thiết.
- Data Success: Dữ liệu sau bóc tách vượt qua khâu kiểm tra nghiệp vụ (không bị null giá, định dạng đúng tiền tệ địa phương).
Sticky Session hay Rotating IP? (rotate for breadth, stick for depth)
Lựa chọn chế độ luân phiên IP quyết định việc luồng thu thập của bạn có ổn định hay không.
- Rotating IP (Đổi IP mỗi request): Đây là chiến thuật ưu tiên khi bạn cần quét diện rộng (thu thập dữ liệu các trang danh mục, quét kết quả tìm kiếm – SERP). Việc phân tán hàng vạn request lên hàng vạn IP dân cư khác nhau giúp bạn thu thập lượng dữ liệu mở rộng mà không bị nghẽn bởi Rate-Limit của site mục tiêu.
- Sticky Session (Giữ IP cố định): Khi pipeline của bạn phải xử lý luồng thao tác đa bước có trạng thái (stateful), ví dụ: vượt qua bước điền bộ lọc (filter), thêm hàng vào giỏ, hoặc lật trang danh sách đằng sau một tài khoản xác thực. Nếu bạn đổi IP liên tục giữa các bước này, WAF sẽ nghi ngờ đây là hành vi chiếm đoạt phiên (Session Hijacking) và ngắt kết nối. Việc giữ một IP cố định trong 5 đến 30 phút giúp giả lập hành vi người dùng tự nhiên.
Ngăn chặn hiện tượng ô nhiễm Pool (Pool Contamination)
Đừng dồn tất cả target domain vào dùng chung một nhóm proxy. Nếu bạn dùng một dải proxy để quét giá cập nhật liên tục (5 phút/lần) trên một trang TMĐT có độ đối kháng cao, dải IP đó sẽ nhanh chóng cạn kiệt điểm tín nhiệm (trust score). Khi bạn tận dụng chính IP đó để thu thập dữ liệu một trang khác, nó sẽ bị chặn không mong muốn. Hãy chia nhỏ proxy pool theo từng target hoặc phân cấp luồng công việc để bảo vệ chất lượng của IP.
Quản trị Rate-Limit và xử lý bão Request: Khắc phục lỗi Clamping
Khi mục tiêu quá tải hoặc hệ thống của bạn gửi request quá nhanh, các mã HTTP 429 hoặc 500+ sẽ xuất hiện. Nếu hàng trăm worker đều chờ đúng 2 giây rồi đồng loạt gửi lại request, máy chủ sẽ bị dội bom và sập lần nữa. Đây gọi là hiện tượng Thundering Herd (Cơn bão retry).
Tại sao Decorrelated Jitter không còn là lựa chọn phù hợp?
Trước đây, nhiều kiến trúc sư phần mềm khuyên dùng thuật toán Decorrelated Jitter (thời gian chờ ngẫu nhiên dựa trên thời gian chờ của lần thử ngay trước đó) để làm mịn lưu lượng.
Tuy nhiên, các báo cáo phân tích hiệu năng gần đây chỉ ra một lỗ hổng kỹ thuật gọi là Clamping (Kẹp giá trị). Khi hệ thống gặp lỗi liên tục, công thức của Decorrelated Jitter khiến khoảng thời gian chờ tăng quá nhanh và nhanh chóng bị kẹp chặt tại mức giới hạn trần (max_delay). Khi phần lớn worker đều bị kẹp ở giới hạn này, tính ngẫu nhiên (jitter) biến mất, và các request lại bắt đầu hội tụ đồng loạt, tạo ra một cơn bão retry mới.
Tối ưu hóa bằng Full Jitter
Giải pháp hiệu quả, được kiểm chứng thực tế và có khối lượng tính toán nhẹ hơn nhiều là quay về thuật toán Exponential Backoff kết hợp Full Jitter.
Nguyên lý của nó rất đơn giản nhưng mang lại khả năng phân bổ lưu lượng vượt trội:
sleep_time = random_between(0, min(max_delay, base_delay * (2 ^ attempt)))
Thay vì giới hạn giá trị ngẫu nhiên dựa vào lần chạy trước, Full Jitter trải đều khả năng worker thức dậy từ 0 giây cho đến mức trần lũy thừa hiện tại. Cách tiếp cận này giảm thiểu triệt để tổng lượng công việc dồn ép lên hệ thống và là cấu hình được khuyến nghị cài đặt trong các HTTP Client của Worker.
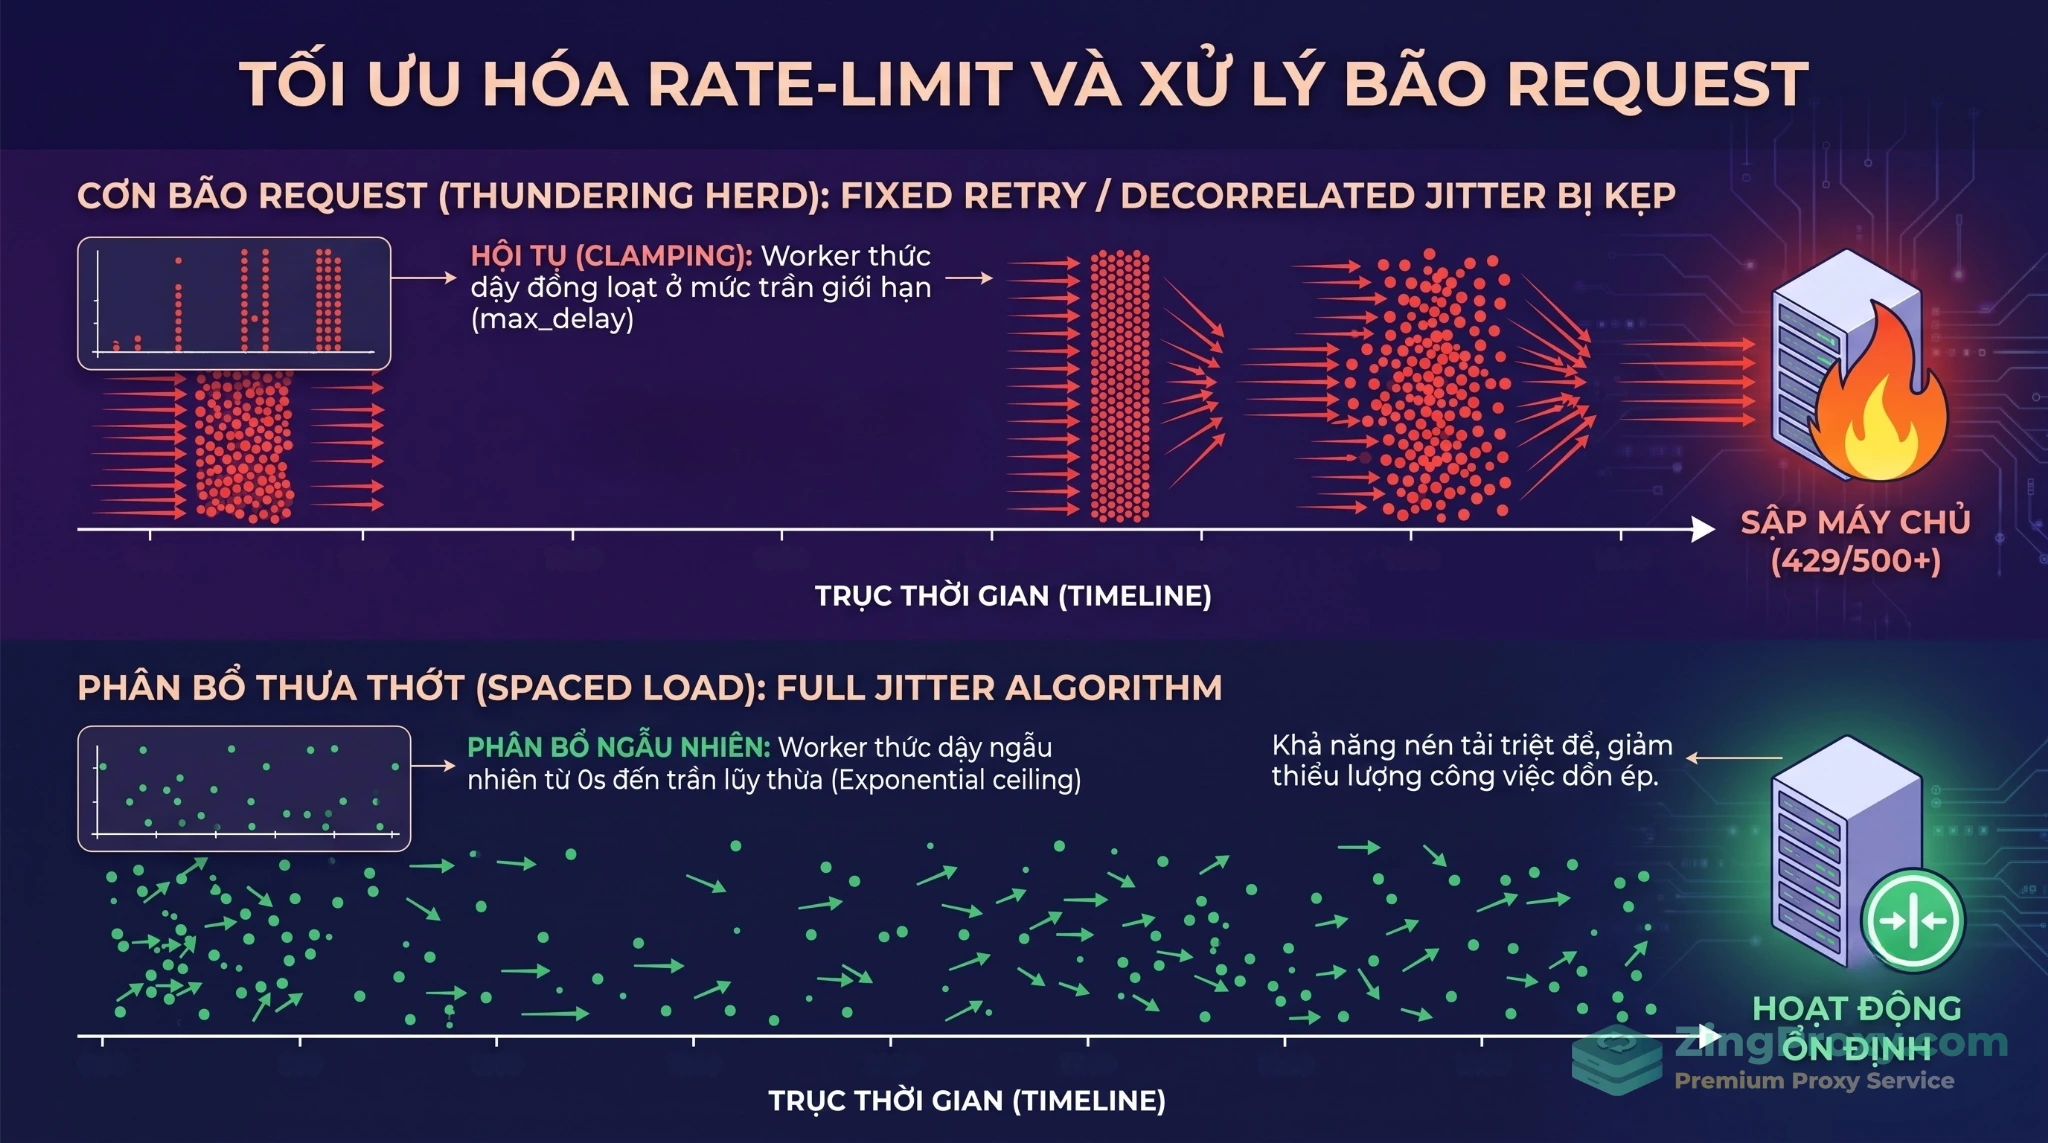
Thuật toán Full Jitter làm mịn lưu lượng request, giúp máy chủ mục tiêu có không gian phục hồi và ngăn chặn lỗi 429.
Giám sát hiệu suất (Observability) bằng Telemetry
Một hệ thống tự động quy mô lớn không thể vận hành theo cảm tính. Các Data Engineer cần tích hợp luồng Telemetry (như Prometheus + Grafana) để theo dõi sức khỏe của toàn bộ Data Pipeline theo thời gian thực.
- P95 Latency (Thời gian phản hồi phân vị 95): Đo lường độ trễ từ lúc gửi đến lúc nhận phản hồi. Khác với số trung bình (average) dễ bị nhiễu, P95 phản ánh chính xác độ trễ mà 95% lượng request của bạn đang phải gánh. Nếu P95 vọt lên quá cao, đó là dấu hiệu Web Unlocker đang phải chật vật giải CAPTCHA hoặc location mạng đang bị nghẽn.
- Block Rate Alerting: Thiết lập bộ đếm tỷ lệ mã lỗi 403, 429 và cả lỗi Parsing Success (phát hiện soft-ban). Khi Block Rate vượt mốc 2% hoặc Success Rate giảm dưới 95% trong 5 phút liên tục, hệ thống cần tự động bắn cảnh báo (Alert) về Slack hoặc PagerDuty để đội kỹ thuật can thiệp.
Nguyên tắc đạo đức trong thu thập dữ liệu (Ethical Scraping)
Phát triển một Data Pipeline mạnh mẽ bằng công nghệ hiện đại không đồng nghĩa với việc lạm dụng nó. Để đảm bảo hệ thống vận hành bền vững, lâu dài và không vướng rủi ro pháp lý, việc tuân thủ đạo đức thu thập (Ethical Scraping) là ranh giới bắt buộc.
- Tập trung vào dữ liệu công khai: Crawler của bạn chỉ nên tương tác với các nguồn thông tin public (giá cả, thông số sản phẩm, ranking, lượt đánh giá). Tuyệt đối không can thiệp, bypass màn hình đăng nhập (login wall) để lấy dữ liệu riêng tư khi chưa được cấp phép.
- Làm sạch dữ liệu hệ thống (Data Sanitization): Ngay tại khâu xử lý luồng, hệ thống parser cần được lập trình để tự động cắt bỏ (strip), mã hóa các chuỗi ký tự nhạy cảm liên quan đến token truy cập, session cookie hoặc thông tin hạ tầng mạng trước khi đưa vào kho Data Warehouse nhằm đảm bảo bảo mật hệ thống.
- Tôn trọng hạ tầng mục tiêu: Tuân thủ các quy tắc trong tệp
robots.txt, thiết lập giới hạn concurrency (số request đồng thời) vừa phải để không gây ảnh hưởng đến hiệu năng máy chủ của đối tác.
- Nguồn gốc IP minh bạch: Đảm bảo các đối tác cung cấp Proxy hoặc Web Unlocker áp dụng quy trình lấy IP có sự đồng thuận rõ ràng từ người dùng mạng (opt-in consent) và tuân thủ các chuẩn mực dữ liệu hiện hành.
Câu hỏi thường gặp (FAQ)
1. Tại sao ưu tiên Proxy Dân cư trong Market Research thay vì Datacenter IP?
Datacenter IP dễ bị WAF (Cloudflare, DataDome) chặn (lỗi 403) do lộ dải ASN thương mại. Proxy dân cư sử dụng IP thiết bị thật, giúp vượt rate-limit và thu thập dữ liệu giá cả chính xác theo đúng vị trí địa lý.
2. Có nên tự xây Proxy Gateway (Nginx/HAProxy) trên VPS để quản lý request?
Không còn thực sự hiệu quả về mặt vận hành. Thay vì tự xoay IP và giải CAPTCHA thủ công, pipeline hiện đại chuyển sang tích hợp Web Unlocker (Scraping API) qua một endpoint để tiết kiệm chi phí bảo trì.
3. Rotating IP và Sticky Session khác biệt cốt lõi ở đâu?
Rotating IP (đổi IP liên tục) dùng để quét diện rộng các trang danh mục. Sticky Session (giữ IP 5-30 phút) dùng cho các luồng có trạng thái như điền bộ lọc (filter) hoặc mô phỏng hành vi thêm vào giỏ hàng.
4. Tại sao khuyên dùng thuật toán Full Jitter để xử lý rate-limit?
Khi hệ thống báo lỗi 429, Full Jitter rải rác thời gian chờ (retry) ngẫu nhiên thay vì để các worker đồng loạt đâm request trở lại, giúp ngăn chặn hiện tượng dội bom máy chủ (Thundering Herd).
5. Làm sao để pipeline thu thập dữ liệu tuân thủ tính minh bạch (Ethical Scraping)?
Chỉ thu thập dữ liệu công khai, cấu hình delay tuân thủ robots.txt, và bắt buộc tích hợp bộ lọc làm sạch dữ liệu hệ thống, loại bỏ các token truy cập nhạy cảm trước khi lưu vào Data Warehouse.
Kết luận
Xây dựng một Data Pipeline thị trường hiệu suất cao là một quá trình cải tiến liên tục. Bằng cách cập nhật từ mô hình Gateway thủ công sang các Scraping API chuyên dụng, kết hợp giả lập TLS Fingerprint đúng cách và ứng dụng thuật toán Full Jitter để xử lý Rate-Limit, các kỹ sư có thể duy trì ứng dụng Proxy dân cư trong Market Research một cách bền vững. Hệ thống đạt tỷ lệ thành công cao và mang về nguồn dữ liệu tin cậy, minh bạch, tạo ra lợi thế cạnh tranh cốt lõi cho mọi quyết định phân tích nghiệp vụ.
Tài liệu tham khảo