Bạn đang vận hành một Data Pipeline thu thập hàng trăm nghìn log giao dịch mỗi giây từ hàng trăm chi nhánh đổ về cụm Kafka trung tâm? Mọi thứ chạy rất mượt trên môi trường staging. Nhưng khi đưa lên production, ác mộng bắt đầu: hệ thống liên tục báo lỗi connection refused, timeout, hoặc tệ hơn là bị API đối tác ném thẳng mã lỗi 429 (Too Many Requests). Log dmesg trên server ngập tràn dòng chữ cảnh báo đỏ chót: nf_conntrack: table full, dropping packet.
Nhiều developer chọn cách vội vã tăng RAM, nâng cấp CPU hay nhồi nhét thêm hàng loạt Elastic IP vào NAT Gateway. Nhưng đó chỉ là cách lấy vải thưa che mắt thánh. Vấn đề cốt lõi không nằm ở sức mạnh tính toán của server, mà nằm ở kiến trúc điều phối lưu lượng outbound (Egress traffic). Khi hàng chục nghìn luồng request cùng chen lấn qua một egress point duy nhất, điểm nghẽn là điều tất yếu.
Vậy làm thế nào để các ông lớn công nghệ xử lý bài toán scale này mà không làm gián đoạn luồng dữ liệu thời gian thực? Câu trả lời nằm ở việc xây dựng hệ thống cấu hình Proxy Pool tự động, một lớp Traffic Orchestration thông minh nằm giữa Data Pipeline và Internet. Hãy cùng bóc tách kiến trúc enterprise-grade này ngay dưới đây!
Nỗi đau của hệ thống phân tán: Khi Data Pipeline nghẹt thở vì giới hạn hạ tầng
Hầu hết các lỗi mạng bí ẩn, chập chờn trong môi trường microservices hoặc hệ thống phân tán đều bắt nguồn từ những giới hạn phần cứng và giao thức mạng mà chúng ta thường bỏ quên lúc thiết kế kiến trúc.
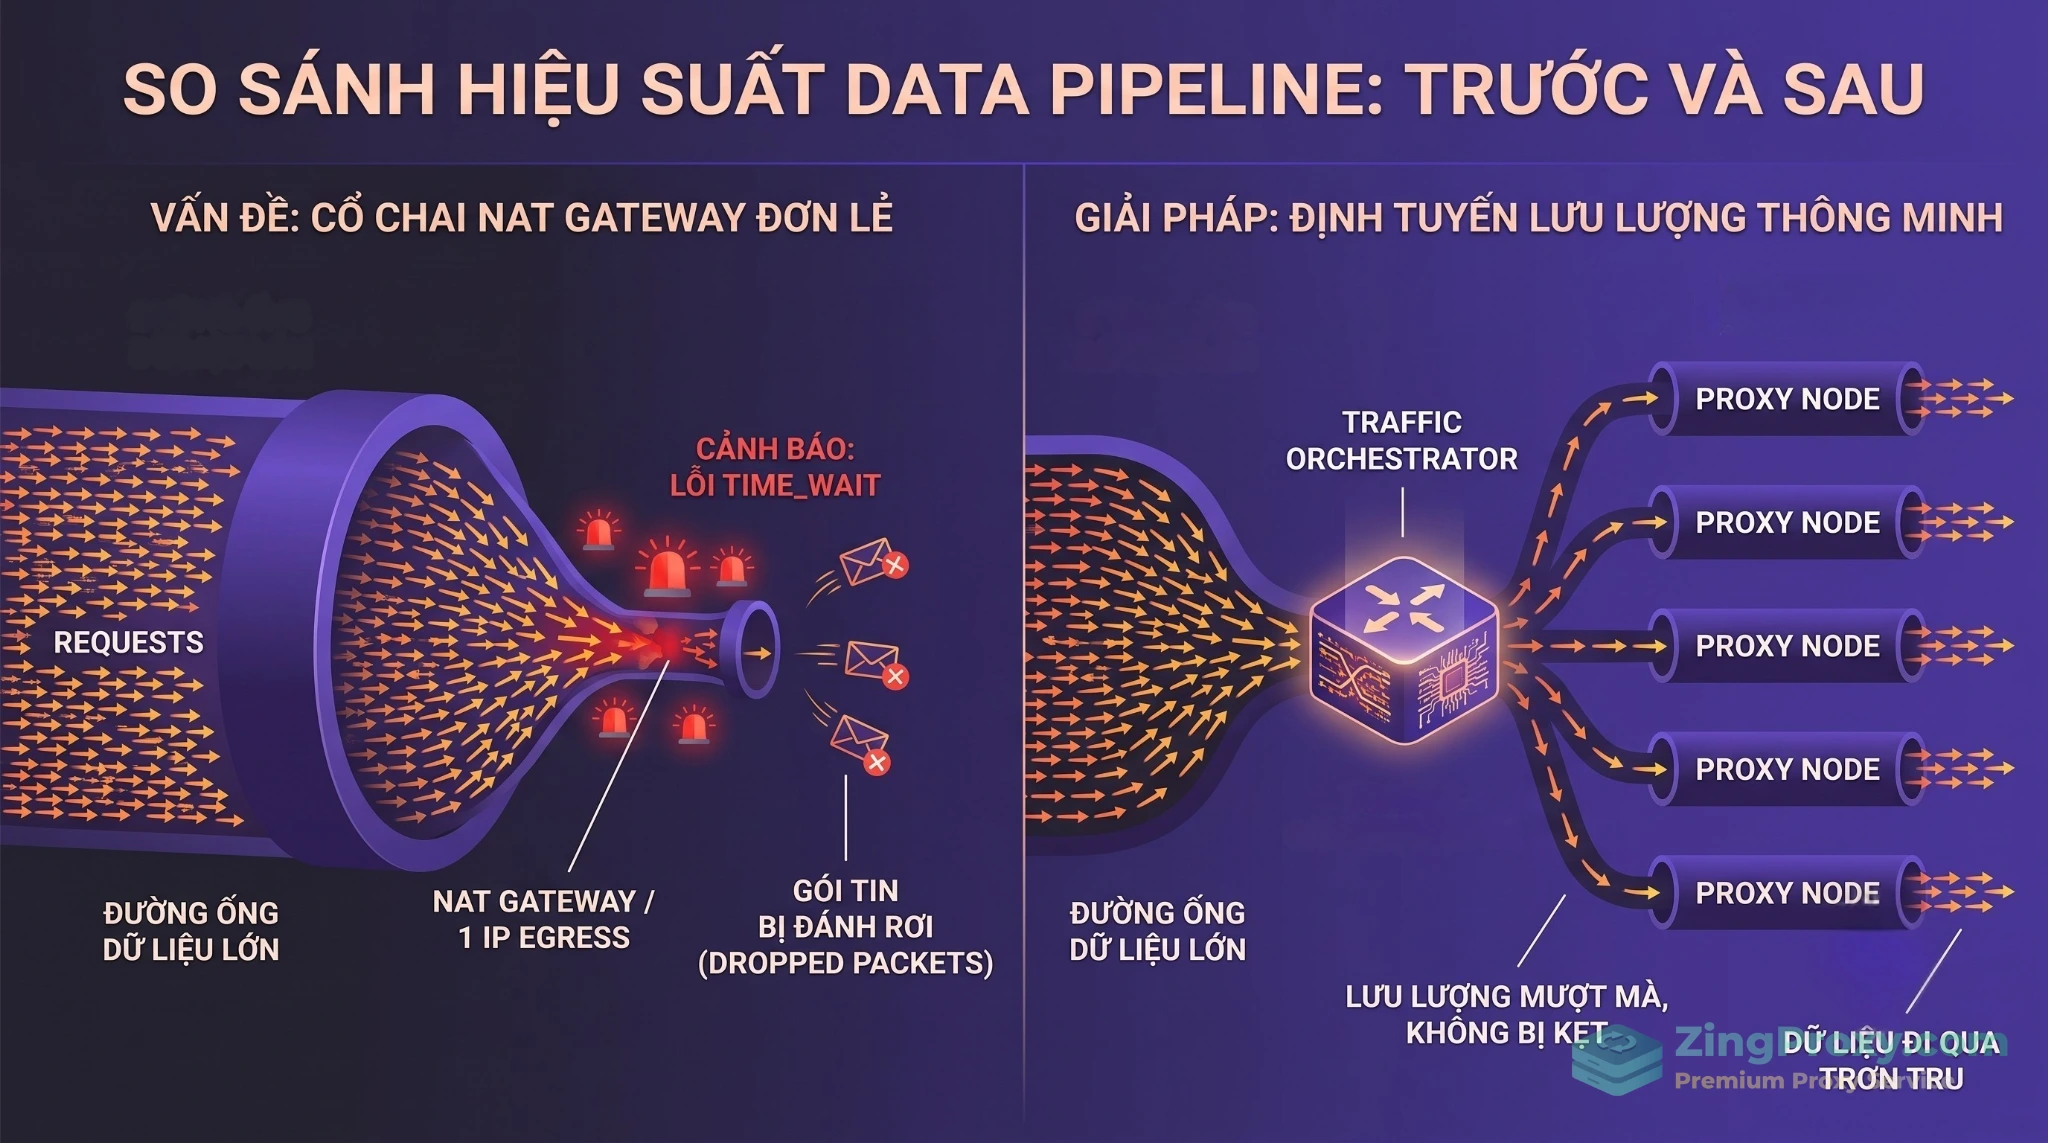
Nút thắt cổ chai mang tên NAT Port Exhaustion (nghẽn cổng NAT)
NAT Port Exhaustion (Cạn kiệt cổng dịch địa chỉ mạng) là kẻ thù thầm lặng giết chết các Data Pipeline quy mô lớn. Về mặt kỹ thuật, một địa chỉ IP công khai chỉ có tối đa khoảng 64.512 cổng ephemeral (từ dải 1024 đến 65535) khả dụng cho việc NAT outbound.
Khi hệ thống của bạn mở hàng chục nghìn kết nối đồng thời đến cùng một đích duy nhất (ví dụ: một API endpoint cố định của đối tác), bộ 5-tuple định danh kết nối (Source IP, Source Port, Dest IP, Dest Port, Protocol) chỉ còn duy nhất một biến số là Source Port để phân biệt các luồng. Ngay cả khi kết nối đã hoàn tất quá trình truyền tải, giao thức TCP vẫn giữ cổng đó ở trạng thái TIME_WAIT từ 60 đến 120 giây để dọn dẹp các gói tin đi lạc (delayed packets).
Thử làm một phép tính nhanh: Nếu Pipeline của bạn gửi 500 requests/giây dạng short-lived connections, số cổng bị giam lỏng trong TIME_WAIT sẽ là $500 \times 60 = 30.000$ cổng. Chỉ trong vòng vỏn vẹn 2 phút, toàn bộ dải port của NAT Gateway sẽ bị hút cạn sạch. Hậu quả là các tiến trình worker mới không thể khởi tạo kết nối, dẫn đến timeout hàng loạt.
Giới hạn cổng NAT là nguyên nhân hàng đầu gây nghẽn cổ chai luồng request. Phân tán lưu lượng qua Proxy Pool là cách duy nhất để loại bỏ điểm nghẽn này.
Single Point of Failure và ám ảnh Rate-limit (lỗi 429)
Nếu thoát được cửa ải NAT Gateway, bạn lại đụng độ tường lửa (WAF/API Gateway) của hệ thống đích. Các API hiện đại luôn áp đặt giới hạn rate-limit cực kỳ khắt khe (ví dụ: tối đa 100 requests/IP/phút). Việc toàn bộ lưu lượng Data Pipeline đổ dồn qua một IP công khai duy nhất sẽ ngay lập tức kích hoạt cơ chế phòng vệ của đối tác. Họ sẽ trả về mã lỗi HTTP 429 (Too Many Requests), 403 (Forbidden), hoặc thậm chí IP egress của bạn có thể bị blacklist vĩnh viễn.
Giải phẫu kiến trúc: Tại sao phải xây dựng hệ thống cấu hình Proxy Pool tự động?
Load Balancer (LB) truyền thống sinh ra là để xử lý lưu lượng Inbound (đầu vào). Nếu cố chấp áp dụng LB để giải quyết bài toán Outbound (đầu ra) của Data Pipeline, bạn sẽ nhanh chóng nhận ra sự bất lực của nó trong việc duy trì phiên làm việc chuyên sâu hay tự động xoay vòng IP để bypass rate-limit một cách hợp lệ.
Chuyển dịch từ Proxy tĩnh sang Traffic Orchestration (điều phối lưu lượng động)
Thay vì cấu hình cứng (hardcode) một vài IP Proxy vào ứng dụng, việc xây dựng hệ thống cấu hình Proxy Pool tự động tạo ra một bộ điều phối lưu lượng (Traffic Orchestration Layer) chuyên biệt, tách rời hoàn toàn Control Plane (điều khiển) và Data Plane (chuyển tiếp dữ liệu).
Proxy tĩnh/LB truyền thống: Chỉ kiểm tra sức khỏe ở mức L4 cơ bản. Khi một node proxy mất kết nối, session bị cắt đứt phũ phàng, Data Pipeline buộc phải chạy lại từ đầu (Abort-and-Restart) gây tốn kém tài nguyên.
Traffic Orchestration: Sử dụng cơ chế Sticky Proxying chuyên sâu. Nếu một proxy node ngừng hoạt động giữa chừng, Control Plane tự động phát hiện và gán kết nối sang một IP khác có cùng vị trí địa lý (Geo-location) mà không làm rớt phiên làm việc của tiến trình đồng bộ phía sau.
Đảm bảo đồng bộ dữ liệu thời gian thực (CDC – Change Data Capture) không độ trễ
Trong các luồng Change Data Capture (CDC), tính thứ tự và sự liền mạch của log (như binlog của MySQL, WAL của PostgreSQL) là yếu tố then chốt. Hệ thống Proxy Pool tự động giúp chia nhỏ tải trọng, phân tán luồng request qua hàng nghìn IP và kiểm soát băng thông công bằng (Multi-Tenant Fairness) nhờ các công nghệ cấp thấp. Điều này loại bỏ hoàn toàn hiện tượng noisy neighbor (một tiến trình chiếm hết băng thông của tiến trình khác), đảm bảo dữ liệu thời gian thực luôn được luân chuyển mượt mà với độ trễ tối thiểu.
Bóc tách 5 lớp (Layers) trong kiến trúc Proxy Pool quy mô doanh nghiệp
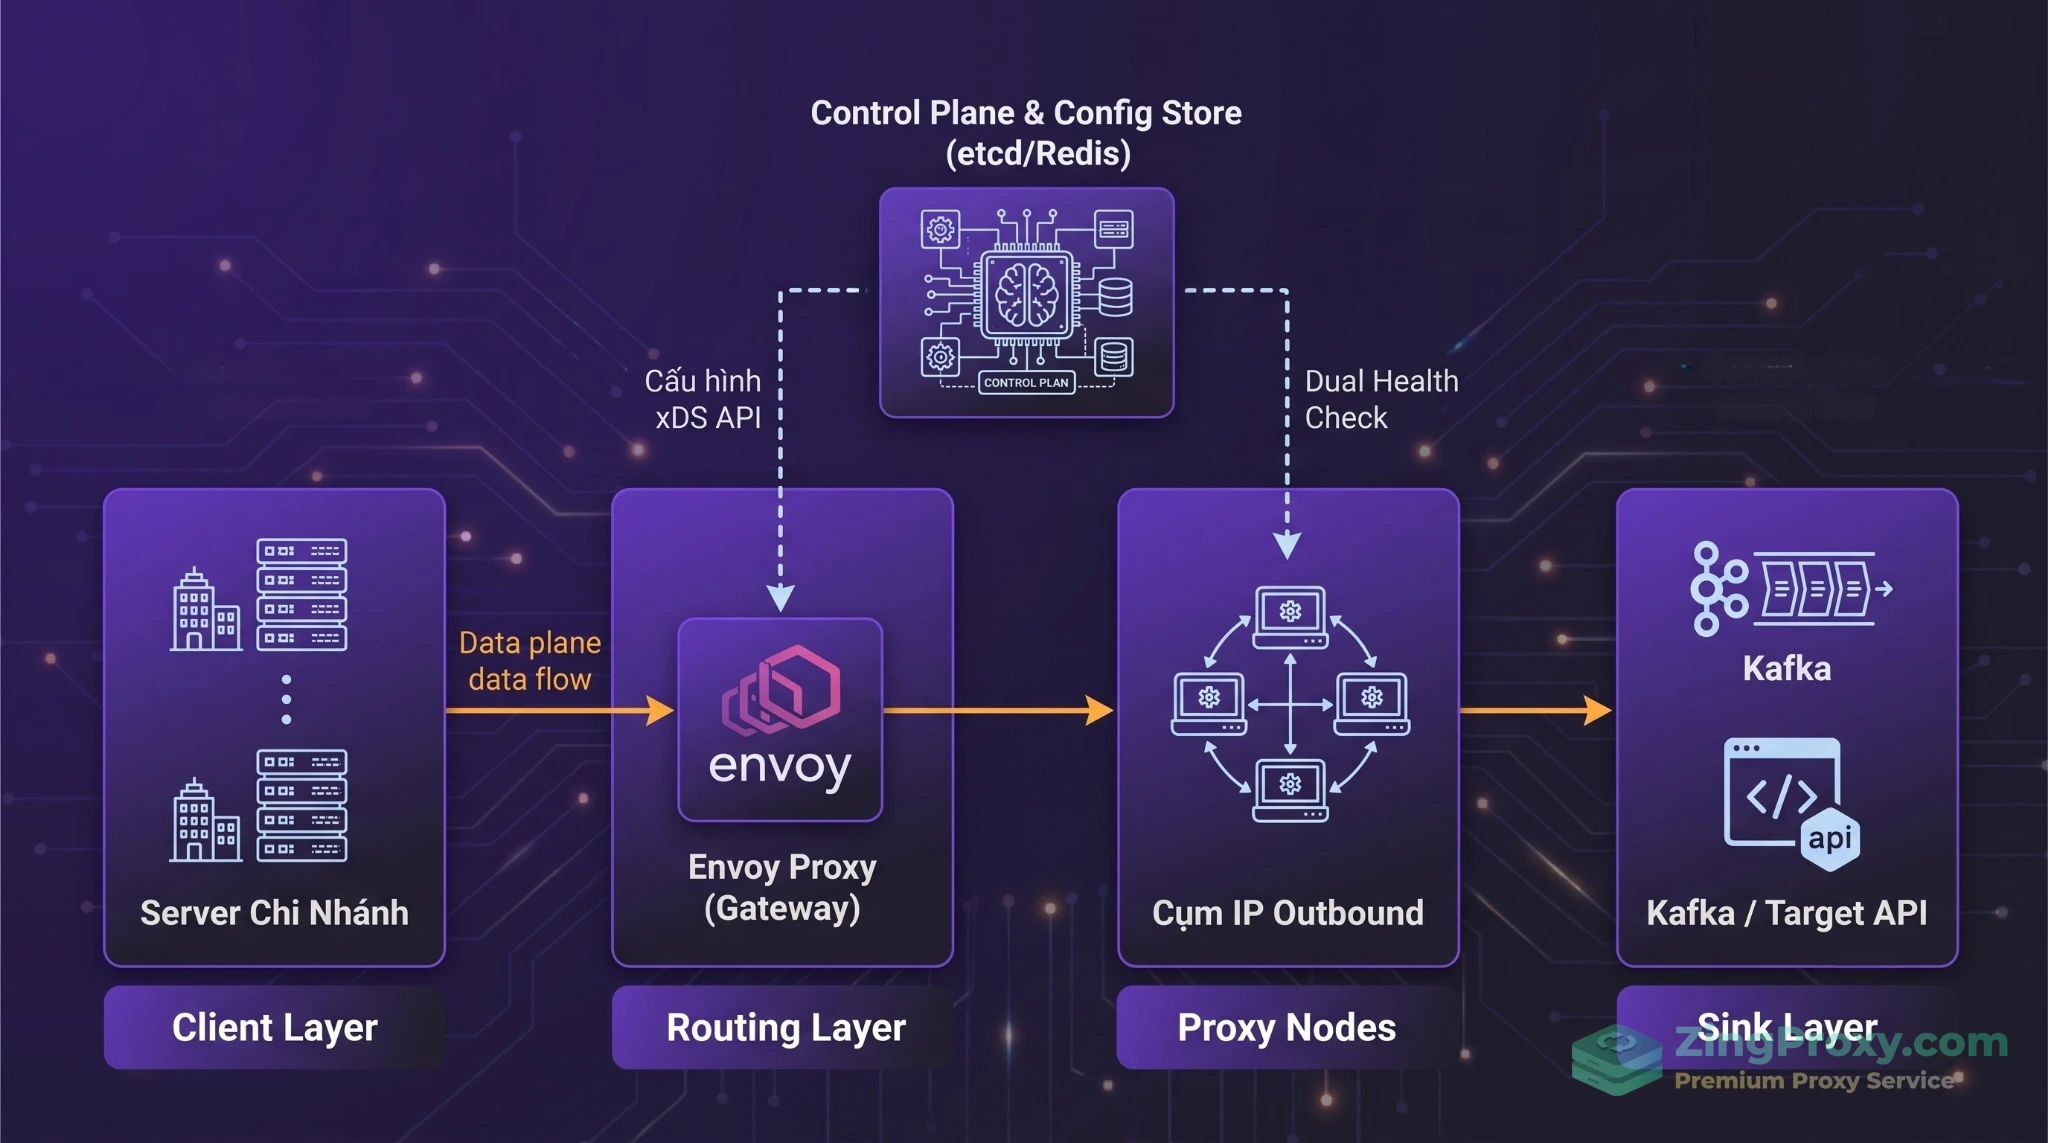
Để một hệ thống có khả năng tự phục hồi (self-healing) và mở rộng linh hoạt (auto-scaling), kiến trúc cần được phân tầng rõ ràng theo chuẩn enterprise:
Client/Ingestion Layer: Các thành phần thu thập dữ liệu tại chi nhánh (như Data Agent, Filebeat, Logstash, hoặc các custom Python/Go workers).
Routing & Load Balancing Layer (Data Plane): Cổng kết nối trung tâm (ví dụ: Envoy Proxy trong kiến trúc Service Mesh, hoặc HAProxy). Lớp này chỉ nhận lệnh và định tuyến (stateless), tuyệt đối không lưu trạng thái.
Proxy Pool Control Plane: bộ não của hệ thống. Chịu trách nhiệm thực hiện Dual Health Check (chủ động/bị động), đánh giá điểm số proxy (Scoring) và ra quyết định xoay vòng (Rotation policy).
Configuration Store (State Store): Nơi lưu trữ trạng thái proxy tập trung. Thường sử dụng etcd, Consul hoặc Redis để đảm bảo đồng bộ cấu hình cấu trúc liên tục.
Sink Layer: Hệ thống đích tiếp nhận dữ liệu như cụm Kafka trung tâm, Data Warehouse (Snowflake, BigQuery), hoặc API đối tác.
Mô hình phân tách rạch ròi giữa Control Plane (điều khiển) và Data Plane (chuyển tiếp) giúp Data Pipeline đạt trạng thái Zero-downtime khi xoay vòng IP.
Thực chiến: 4 bước xây dựng hệ thống cấu hình Proxy Pool tự động
Dưới đây là blueprint kỹ thuật để bạn tự tay xây dựng một cụm Proxy Pool tự động chống chịu được traffic khủng.
Bước 1: Thiết lập Control Plane và Config Store (sử dụng xDS API / EDS)
Để đạt được trạng thái Zero-downtime, Data Plane (như Envoy hoặc HAProxy) tuyệt đối không được khởi động lại tiến trình (reboot process) khi danh sách Proxy IP thay đổi. Cách làm cũ là tự viết code watch etcd đã không còn tối ưu.
Tiêu chuẩn hiện đại là sử dụng xDS API, đặc biệt là EDS (Endpoint Discovery Service).
Khi Control Plane (được lưu trữ trạng thái trên etcd/Consul) phát hiện một proxy mới hoặc proxy bị lỗi, nó sẽ tự động biên dịch thông tin thành cấu hình EDS và đẩy trực tiếp xuống Data Plane qua luồng gRPC. Envoy hay HAProxy (thông qua HAProxy Data Plane API) sẽ tự động cập nhật danh sách upstream endpoints trong bộ nhớ một cách nguyên tử (atomic update). Những active connections cũ vẫn tiếp tục chạy cho đến khi hoàn thành, trong khi toàn bộ request mới được lèo lái sang Proxy mới mà không rớt một gói tin nào.
Bước 2: Triển khai Proxy Nodes trung gian (ưu tiên Go/Rust)
Các Proxy Node là những chiến binh thực sự ở tuyến đầu. Trước đây, nhiều người sử dụng Dante (SOCKS5) viết bằng C, dù ổn định nhưng cấu hình phức tạp và quản lý resource kém.
Hiện nay, hạ tầng Proxy Pool quy mô lớn ưu tiên sử dụng các công cụ viết bằng Go hoặc Rust để tối ưu memory footprint và concurrency:
Resin / GOST (GO Simple Tunnel): Cực kỳ nhẹ, hỗ trợ đa giao thức (HTTP/HTTPS/SOCKS5), dễ dàng container hóa và map IP public riêng biệt.
Xray-core: Hiệu năng cực cao, hỗ trợ các quy tắc định tuyến phức tạp ngay tại node, tối ưu cho việc bảo mật luồng dữ liệu trong lưu lượng lớn.
Bước 3: Lập trình module Dual Health Check và Ejection
Một hệ thống tự động thì không thể thiếu module tự chẩn đoán. Chúng ta áp dụng cơ chế giám sát kép (Dual Monitoring):
Active Health-Check: Control Plane ping liên tục tới IP/Port của Proxy (L4 TCP) và gửi request giả lập (L7 HTTP) mỗi 5 giây. Nếu thất bại 3 lần liên tiếp, proxy bị đưa vào danh sách đen (DOWN).
Passive Outlier Detection: Đây là vũ khí tối thượng của Envoy. Control Plane theo dõi kết quả của luồng traffic thực tế. Nếu proxy A trả về mã 504 Gateway Timeout hoặc 429 Too Many Requests liên tục trên data thực, nó sẽ bị cô lập (ejected) khỏi vòng định tuyến ngay lập tức, mặc kệ việc Active Check vẫn báo đang hoạt động.
Bước 4: Tối ưu với Intelligent Rotation, P2C và Circuit Breaker
Đừng bao giờ dùng thuật toán Round Robin tĩnh để chống rate-limit lỗi 429. Nó quá thụ động. Bạn phải dùng Intelligent Rotation (điều phối thích ứng).
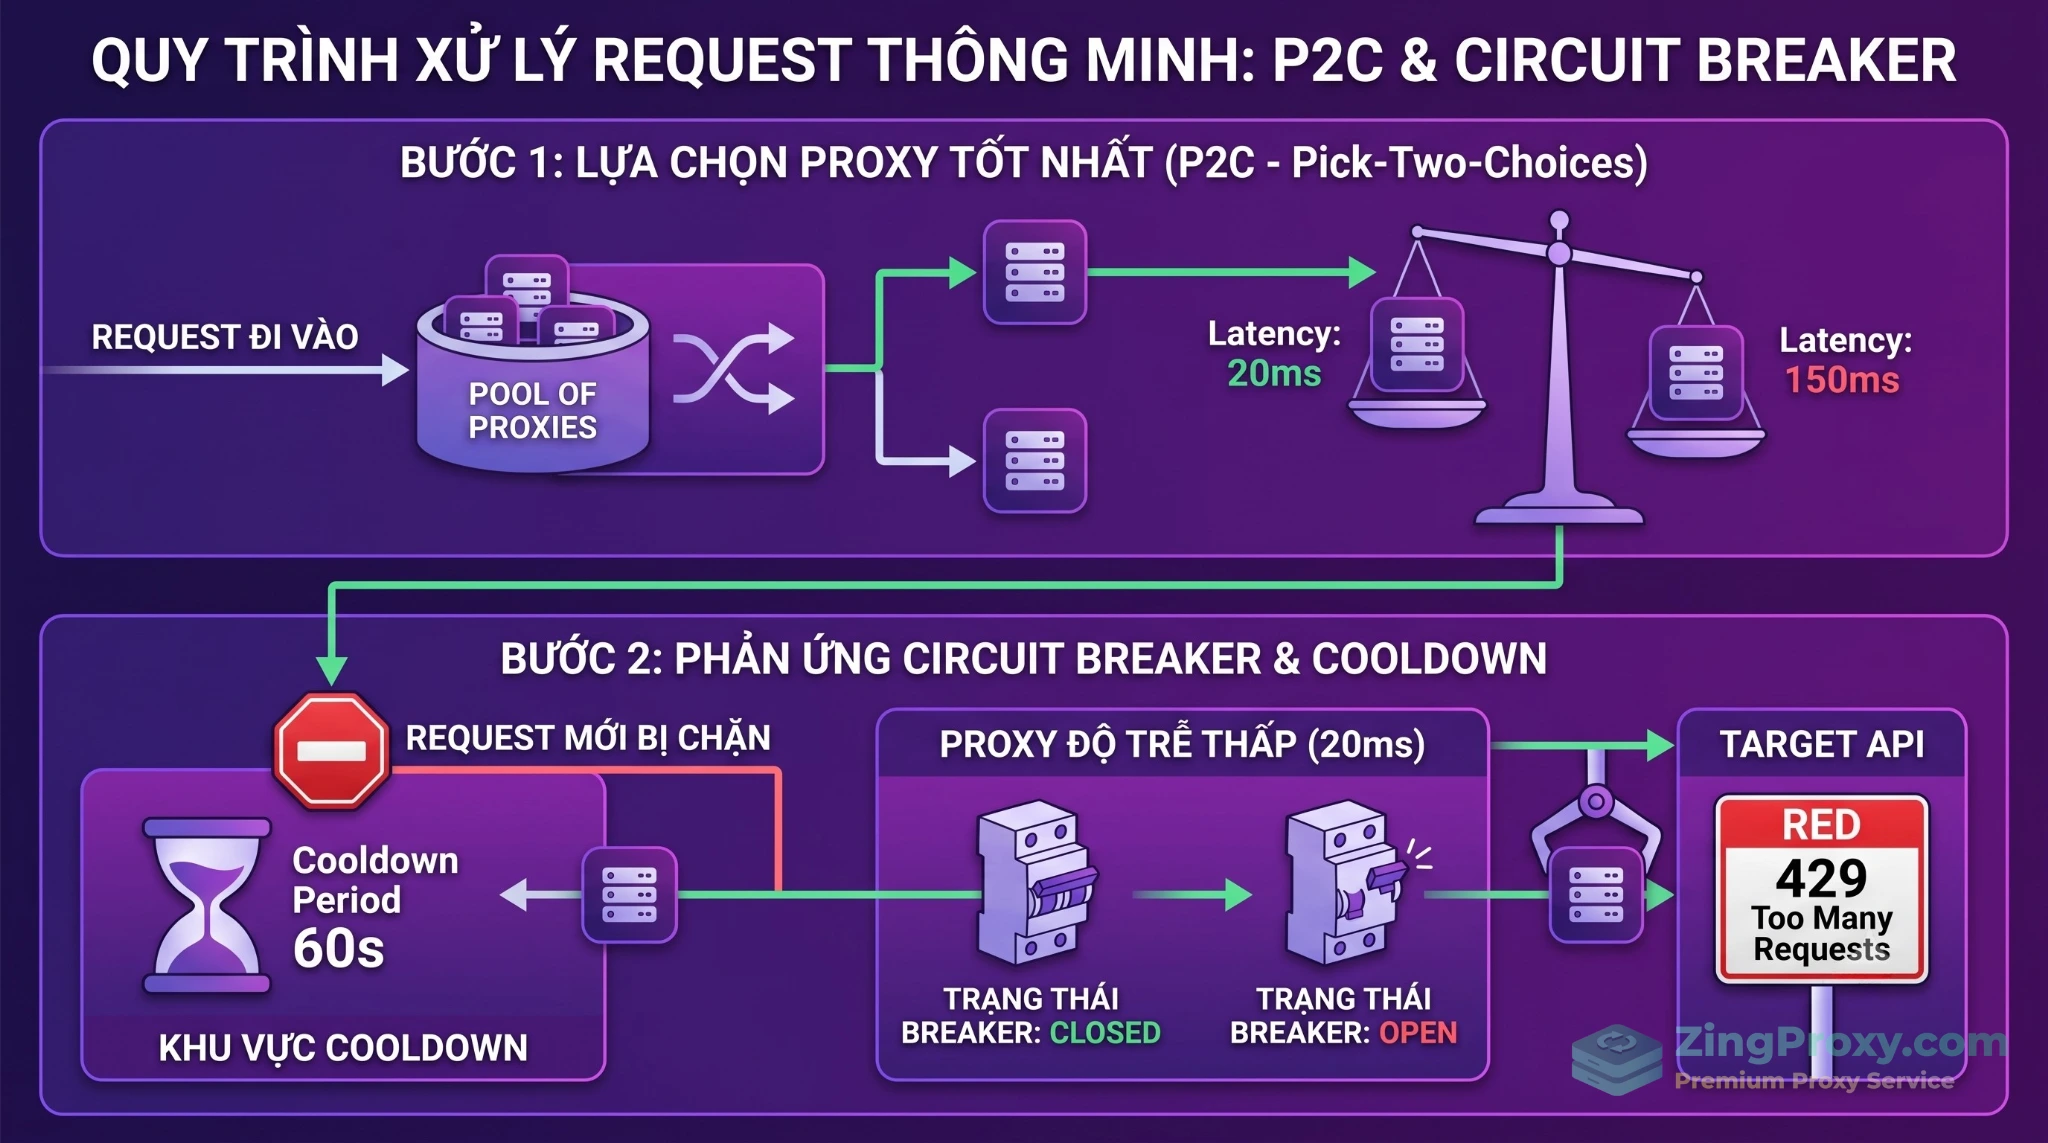
Thuật toán P2C (Power of Two Choices): Thay vì xoay vòng mù quáng theo thứ tự, hệ thống bốc ngẫu nhiên 2 Proxy khỏe mạnh từ Pool, so sánh độ trễ (latency) và số lượng kết nối đang mở của chúng, sau đó đẩy request cho Proxy có điểm số tốt hơn. Cơ chế này triệt tiêu hoàn toàn nút thắt cổ chai cục bộ.
Circuit Breaker (Ngắt mạch thích ứng): Khi nhận HTTP 429 từ target API, IP đó lập tức bị ném vào trạng thái ngắt mạch (Open) và chịu một khoảng thời gian làm nguội (Cooldown Period, ví dụ 30-60 giây) để API đích reset rate limit window. Hết thời gian, nó chuyển sang Half-Open để thả một vài request test thử trước khi đưa hẳn về Pool chính.
Thay vì xoay vòng tĩnh một cách mù quáng, thuật toán P2C và Circuit Breaker chủ động cách ly các Proxy bị rate-limit ra khỏi luồng xử lý để bảo vệ toàn hệ thống.
Tích hợp Proxy Pool vào Data Pipeline thực tế (Zero-intrusion)
Lý thuyết HTTP API là vậy, nhưng khi Data Pipeline của bạn sử dụng giao thức custom TCP nhị phân như Kafka thì sao?
Case study: Xử lý Metadata Loop của Kafka với Envoy Filter và eBPF
Kafka có một đặc điểm gọi là Metadata Loop Trap. Khi Worker kết nối tới Broker, Broker trả về một list IP nội bộ thực tế của cluster. Nếu không xử lý ở tầng proxy, Worker sẽ bypass mọi LB và tự động mở luồng TCP kết nối trực tiếp ra ngoài, phá vỡ hoàn toàn kiến trúc Proxy Pool.
Trước đây, thủ thuật phổ biến là dùng SOCKS5 Sidecar và sửa biến môi trường (như chèn tham số -DsocksProxyHost vào JVM). Tuy nhiên, việc phải sửa code hoặc cấu hình App không phải là Zero-intrusion (không xâm nhập) thực sự.
Giải pháp Enterprise hiện đại:
Envoy Kafka Broker Filter: Envoy Proxy hiện tại đã cung cấp bộ lọc L7 chuyên biệt cho Kafka. Envoy có khả năng đánh chặn (intercept) gói tin MetadataResponse, tự động rewrite danh sách IP của cụm Broker thành IP ảo (hoặc localhost) trước khi trả về cho Client. Nhờ đó, Kafka Worker không hề biết sự tồn tại của Proxy, và luồng traffic Egress vẫn được Envoy lèo lái an toàn qua Proxy Pool.
eBPF / Cilium (Tương lai của Networking): Để đạt mức Zero-intrusion tuyệt đối, kiến trúc hiện tại sử dụng công nghệ eBPF can thiệp thẳng vào Kernel Linux. Cilium/eBPF có thể tự động bắt (intercept) toàn bộ luồng traffic gọi ra Kafka Broker và bẻ lái nó vào Proxy Pool ở tầng không gian hạt nhân, không yêu cầu thay đổi bất kỳ dòng code, tham số JVM hay sidecar nào trên Kafka Worker. Mọi thứ diễn ra trong suốt và có độ trễ cực thấp (< 50µs).
Một khi đã xây dựng hệ thống cấu hình Proxy Pool tự động, bạn phải trang bị mắt thần SRE (Site Reliability Engineering) để giám sát nó. Nếu không, hệ thống sẽ trở thành một chiếc hộp đen rủi ro.
Thu thập Metrics với Prometheus & Grafana
Tuyệt đối không dùng độ trễ trung bình (Average Latency) để đo lường proxy vì nó che lấp các request bị nghẽn cục bộ. Hãy dùng phân vị p95 hoặc p99.
Dưới đây là một PromQL tiêu chuẩn (đã chuẩn hóa cú pháp) để theo dõi độ trễ p99 của Envoy Upstream Cluster:
histogram_quantile(0.99, sum by (le, cluster) (rate(envoy_cluster_upstream_rq_time_bucket[5m])))
Đồng thời, bạn cần thiết lập cảnh báo (Alerting Rules) đẩy về Slack/PagerDuty khi tỷ lệ lỗi vượt quá ngưỡng cho phép. Lưu ý, hãy cập nhật regex để bắt cả lỗi 429 (Rate Limit) bên cạnh nhóm 5xx. Cú pháp kết hợp traffic floor để tránh báo động giả khi lưu lượng thấp:
- alert: ProxyHighErrorRate
  expr: |
    (
      sum by (cluster) (rate(envoy_http_downstream_rq_xx{code=~"429|5.."}[5m]))
      /
      sum by (cluster) (rate(envoy_http_downstream_rq_total[5m]))
    ) * 100 > 5
    and
    sum by (cluster) (rate(envoy_http_downstream_rq_total[5m])) > 1
  for: 5m
  labels:
    severity: critical
Quản lý Secrets, mTLS và RBAC nội bộ
Kiến trúc Proxy luôn tiềm ẩn rủi ro lộ lọt dữ liệu (Man-in-the-Middle) nếu bị sniff giữa chừng.
Luôn áp dụng mTLS (Mutual TLS) giữa Data Agent ở các chi nhánh và Gateway trung tâm để mã hóa toàn bộ payload dữ liệu.
Credentials của các Proxy Nodes không bao giờ được lưu plaintext. Chúng phải được mã hóa và lưu trữ an toàn trong HashiCorp Vault, tự động inject qua memory và truy cập thông qua cơ chế RBAC nội bộ khắt khe.
Câu hỏi thường gặp (FAQ)
1. Tại sao không dùng dịch vụ Managed NAT Gateway của Cloud (như AWS NAT Gateway) thay vì tự xây Proxy Pool?
Cloud NAT chỉ giải quyết lỗi cạn port nội bộ nhưng vẫn đẩy traffic ra ngoài qua một vài IP public cố định. Nó không thể giúp bạn chống lại lỗi 429 (Rate-limit) từ API đối tác như cách Proxy Pool phân tán tải qua hàng nghìn IP.
2. Tại sao Load Balancer truyền thống không thể thay thế Proxy Pool cho Outbound traffic?
Load Balancer được thiết kế chuyên trị traffic đầu vào (Inbound). Trong khi đó, Proxy Pool sinh ra để lèo lái traffic đầu ra (Outbound/Egress), đòi hỏi khả năng xoay vòng IP linh hoạt, ngụy trang kết nối và giữ phiên (sticky routing) sâu mà LB không có.
3. Việc đẩy traffic qua lớp Proxy trung gian có làm tăng độ trễ (latency) của luồng đồng bộ CDC không?
Có tăng (khoảng 1 – 5ms) nhưng không đáng kể. Bù lại, Proxy Pool triệt tiêu tình trạng request bị kẹt (timeout) do nghẽn hàng đợi TCP, giúp tổng thông lượng (throughput) thực tế ổn định và nhanh hơn rất nhiều.
4. Tôi cần chuẩn bị bao nhiêu IP trong Proxy Pool để xử lý tải 10,000 requests/phút?
Phụ thuộc vào giới hạn của đích đến, không phải tải của bạn. Nếu API đích cho phép 100 req/IP/phút, bạn cần tối thiểu 100 IP (10.000/100). Thực tế, luôn áp dụng hệ số dự phòng 1.5x – 2x (cần 150 – 200 IP) để bù đắp cho các IP đang bị ngắt mạch (Cooldown).
5. Khi nào nên dùng Envoy Proxy thay vì HAProxy cho hệ thống Proxy Pool?
Chọn HAProxy khi bạn xử lý luồng TCP/L4 thô, cần một gateway cực nhẹ và cấu hình đơn giản. Chọn Envoy khi kiến trúc là Cloud-Native, cần bóc tách giao thức L7 (như Kafka Broker Filter, gRPC), tích hợp Service Mesh, hoặc dùng xDS API để hot-reload động 100%.
6. Data Pipeline của tôi dùng gRPC (HTTP/2), liệu kiến trúc này có tương thích không?
Hoàn toàn tương thích. Các Data Plane như Envoy hỗ trợ native multiplexing cho gRPC. Nó có thể giữ long-connection với pipeline, đồng thời chẻ nhỏ luồng stream ra nhiều Proxy IP mà không làm gãy kiến trúc.
7. Làm sao để ứng dụng tự nhận diện IP Proxy mới mà không cần khởi động lại (Zero-downtime)?
Sử dụng chuẩn xDS API (như EDS). Control Plane sẽ đẩy thẳng cấu hình IP mới vào vùng nhớ của Data Plane (Envoy) qua gRPC. Ứng dụng ở phía sau tự động cập nhật luồng đi mà không cần bất kỳ lệnh restart nào.
Kết luận
Bài toán nghẽn cổng kết nối NAT hay những cơn mưa mã lỗi 429 không còn là dấu chấm hết cho hệ thống của bạn. Việc xây dựng hệ thống cấu hình Proxy Pool tự động, từ thiết lập Control Plane xDS API, triển khai proxy node bằng Go/Rust, ứng dụng eBPF cho Zero-intrusion, cho đến áp dụng cơ chế ngắt mạch Circuit Breaker, chính là bước tiến hóa tất yếu của mọi hạ tầng Data Pipeline cấp độ doanh nghiệp.
Kiến trúc này không chỉ giúp bạn scale lưu lượng outbound lên vô hạn mà còn cô lập lỗi cực kỳ hiệu quả, đảm bảo dòng chảy dữ liệu thời gian thực luôn thông suốt, bất kể hệ thống đích có thay đổi rule gắt gao đến đâu.
Bạn vừa deploy một LLM agent lên server riêng, cấu hình API key đầy đủ, nạp toàn bộ tài liệu nội bộ vào vector database và yên tâm rằng hệ thống đã an toàn vì tường lửa Ingress bảo vệ vững chắc. Nhưng sáng hôm sau, hóa đơn cloud tăng vọt, hoặc tệ hơn, thông […]
Hiện tượng CPU peak (chạm ngưỡng 100%) và hàng loạt lỗi 504 Gateway Timeout là viễn cảnh cực kỳ quen thuộc đối với các backend developer khi vận hành hệ thống Microservices trên những VPS có cấu hình giới hạn (1 vCPU, 1-2GB RAM). Bạn thuê một máy chủ ảo, triển khai vài service Spring […]
Tháng 10 năm 2025 có lẽ là thời điểm ám ảnh đối với nhiều Solutions Architect và DevOps Engineer. Lỗi tự động hóa DNS tại us-east-1 của AWS đã kéo theo sự sụp đổ dây chuyền của hàng loạt dịch vụ phụ thuộc trên toàn cầu, khiến hàng ngàn nền tảng SaaS tê liệt. Cùng […]
Một buổi sáng thức dậy, bạn nhận được cảnh báo CPU máy chủ spike lên 100%. Mở terminal SSH vào kiểm tra log, bạn bàng hoàng phát hiện một tiến trình lạ đang chạy ngầm dưới quyền user git, hệ thống CI/CD pipeline tự động chèn mã độc vào bản build, và mã nguồn dự […]
Bạn vừa deploy một cụm server inference với kỳ vọng xử lý trơn tru hàng loạt request ngữ cảnh dài từ các ứng dụng tác tử (AI agents), nhưng lại quên mất việc quản lý Proxy Pool cho AI Agent để điều phối luồng truy cập. Thực tế ập đến: chỉ với vài phiên làm […]
Khi hệ thống tự động hóa của bạn bắt đầu scale từ một vài script thử nghiệm lên hàng chục, hàng trăm luồng worker chạy song song, màn hình console thường bắt đầu xuất hiện một nỗi đau quen thuộc: các dòng log đỏ rực báo lỗi HTTP 429 Too Many Requests. Workflow bị gãy […]