Bạn vừa deploy một cụm server inference với kỳ vọng xử lý trơn tru hàng loạt request ngữ cảnh dài từ các ứng dụng tác tử (AI agents), nhưng lại quên mất việc quản lý Proxy Pool cho AI Agent để điều phối luồng truy cập. Thực tế ập đến: chỉ với vài phiên làm việc đẩy 1 triệu token context vào hệ thống, log server lập tức báo lỗi bởi hàng loạt mã OOM (Out-of-Memory) và 504 Gateway Timeout. Độ trễ TTFT (Time-to-First-Token) tăng lên hàng chục giây và toàn bộ luồng dữ liệu trả về bị nghẽn.
Đây là bài toán phổ biến của mọi Kỹ sư hệ thống và developer khi đối mặt với mô hình ngôn ngữ quy mô lớn. Việc tăng thêm RAM máy chủ không giải quyết được vấn đề gốc rễ của luồng xử lý AI. Để gánh vác khối lượng tính toán lớn này, việc thiết lập một hạ tầng VPS chạy DeepSeek V4.1 kết hợp reverse proxy, hàng đợi bất đồng bộ (Asynchronous Queue) và kiến trúc phân rã EPD (EPD Disaggregation) là yêu cầu mang tính thiết yếu.
Vậy làm thế nào để biến một VPS gateway thành tấm khiên định tuyến thông minh, phân bổ tải hợp lý và bảo vệ nguyên vẹn băng thông bộ nhớ của cụm GPU phía sau? Hãy cùng phân tích kiến trúc hạ tầng chuyên sâu, bám sát các bản cập nhật công nghệ của hệ sinh thái DeepSeek ngay sau đây.
Nỗi đau OOM và bản chất kiến trúc của DeepSeek V4.1
Trước khi can thiệp vào tầng network hay proxy, chúng ta cần nhìn thẳng vào sự thật của việc phục vụ (serving) một mô hình có độ dài ngữ cảnh đạt mức 1.048.576 token. Nhiều kỹ sư thường mang tư duy triển khai web server truyền thống áp dụng vào LLM, dẫn đến sự sụp đổ dây chuyền khi hệ thống đối mặt với tải trọng thực tế.
Giải mã Causal Encoder-Decoder: Tải trọng thực tế 8B vs 16B
Một hiểu lầm phổ biến trong giới vận hành là khi nhìn vào con số tổng 552 tỷ tham số (552B) và 196B tham số bảng Engram, nhiều người cho rằng cụm máy chủ phải gánh tải tính toán toàn phần cho mỗi request.
Điểm đột phá của hệ thống nằm ở kiến trúc Causal Encoder-Decoder (CED). Kiến trúc này cho phép mô hình hoạt động theo cơ chế kích hoạt thưa (sparse activation) được thiết kế tinh gọn. Cụ thể, mô hình chỉ kích hoạt khoảng 8 tỷ (8B) tham số cho mỗi token ở pha xử lý đầu vào (Prefill) và 16 tỷ (16B) tham số ở pha sinh chuỗi (Decode).
Cơ chế này giúp giảm khối lượng tính toán ở pha Prefill so với các mô hình trước đây, mang lại hiệu quả về mặt chi phí cho các luồng công việc ngốn nhiều context. Dù vậy, không gian lưu trữ tĩnh để nạp trọng số (Model Weights) lên VRAM vẫn cần hàng trăm GB, đòi hỏi một chiến lược tối ưu chi phí VPS chạy AI thông minh với các GPU chuyên dụng (như H200 hoặc Blackwell) đứng ngay phía sau lớp VPS điều phối.
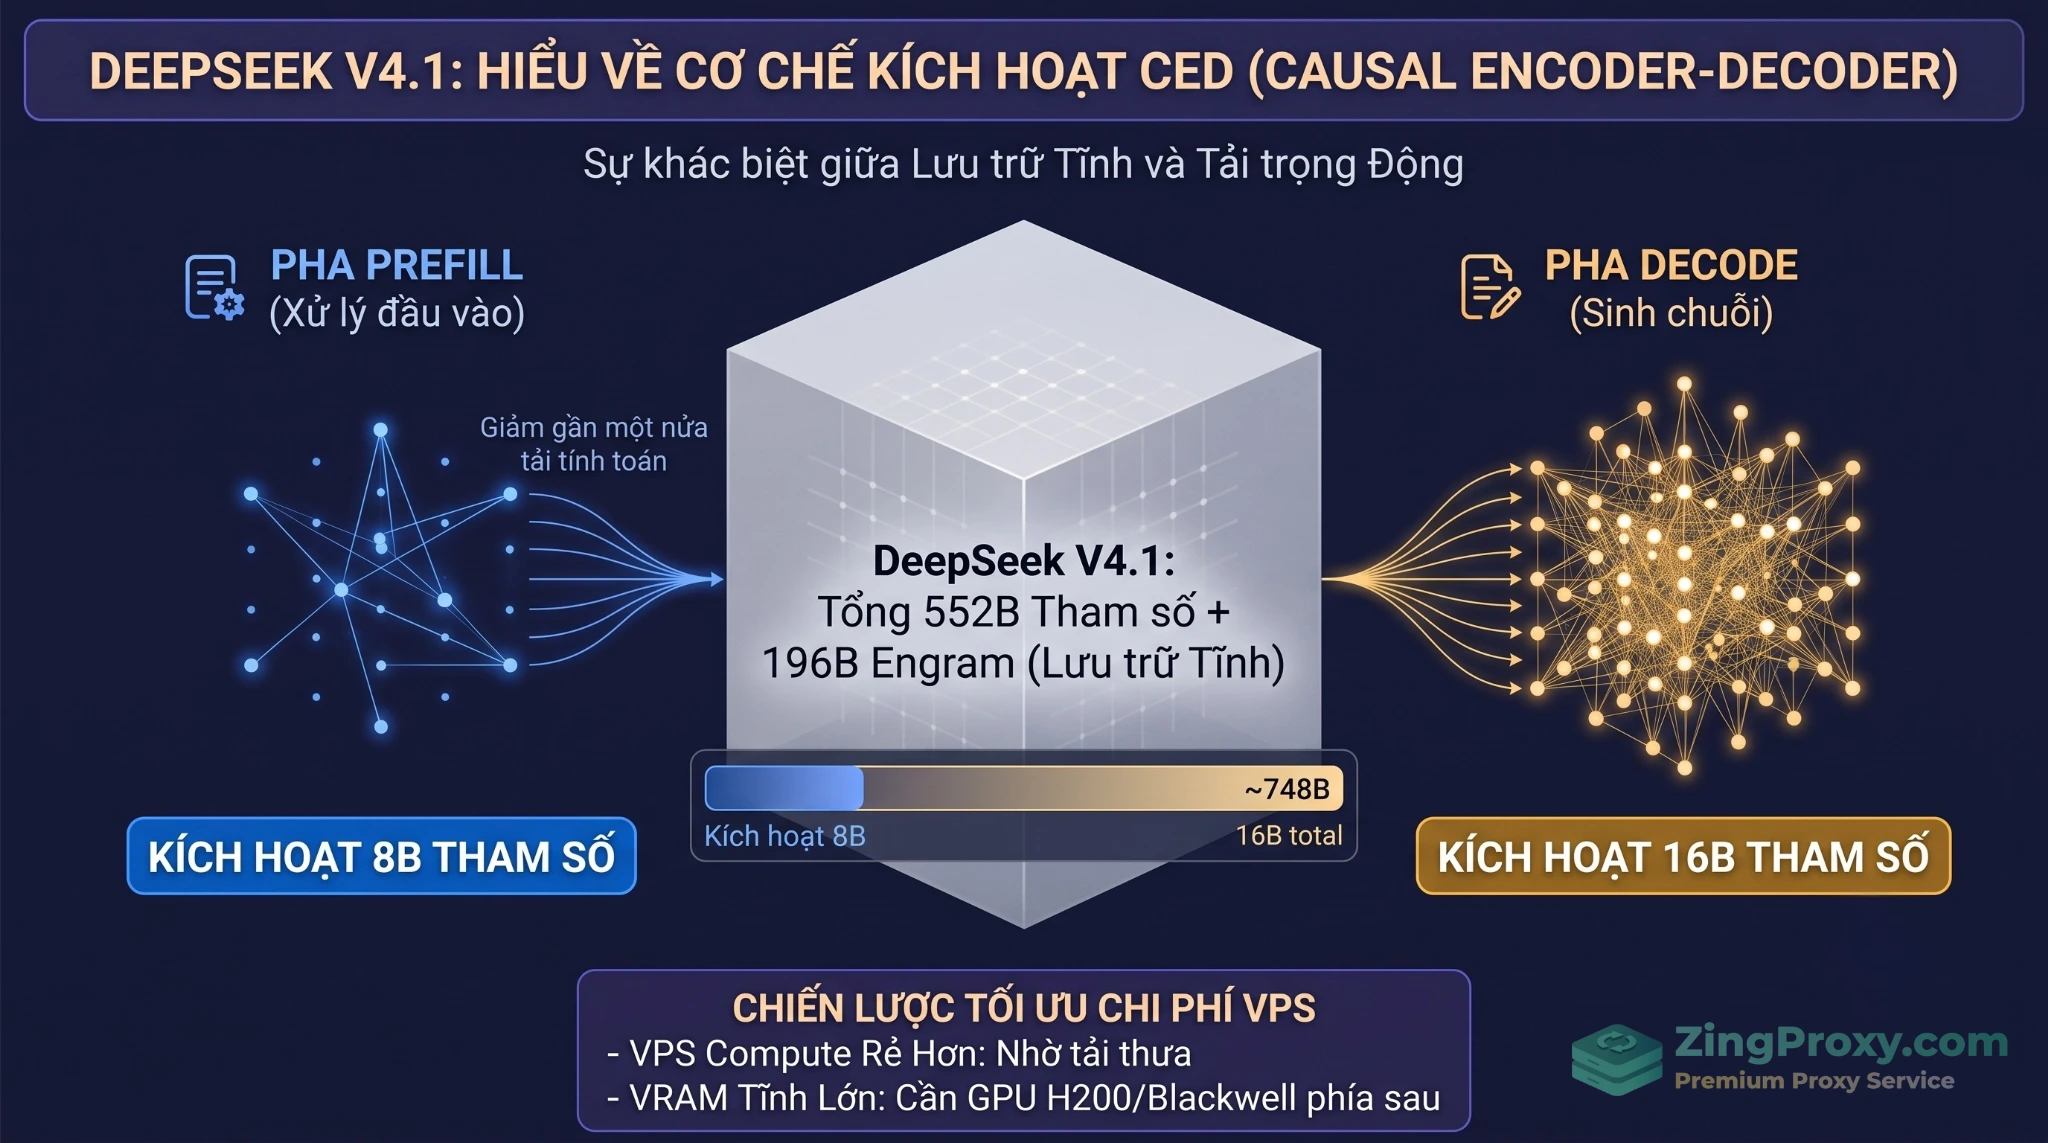
Kiến trúc CED giúp tối ưu khối lượng tính toán bằng cách chỉ kích hoạt một phần nhỏ tham số ở mỗi pha xử lý thay vì toàn bộ mô hình.
Nút thắt 1 triệu token & đột phá FP4 KV caching
Quá trình suy luận (inference) tồn tại một sự xung đột tài nguyên giữa hai pha xử lý:
- Prefill (Xử lý đầu vào): Tiêu thụ lượng lớn năng lực tính toán ma trận (Compute-Bound).
- Decode (Sinh token tự hồi quy): Bị giới hạn hoàn toàn bởi băng thông bộ nhớ để nạp rút dữ liệu (Memory-Bandwidth-Bound).
Khi dồn một truy vấn 1M token vào một node độc lập, hàng nghìn Tensor Cores sẽ bị phân bổ để xử lý phép tính cho pha Prefill. Trong khoảng thời gian đó, hệ thống rơi vào trạng thái Decode Stalls, khiến các request khác đang ở pha sinh token bị đóng băng, làm chỉ số độ trễ P99 TTFT tăng đột biến.
Để xử lý bài toán dung lượng bộ nhớ khi context lên tới 1 triệu token, công nghệ ép nén đã có nhiều cải tiến. Thay vì sử dụng chuẩn FP8 như các phiên bản cũ, DeepSeek V4.1 hỗ trợ FP4 KV caching. Khi kết hợp định dạng FP4 với kiến trúc Compressed Sparse Attention 2 (CSA2), dung lượng global KV cache được ép xuống chỉ còn khoảng 890 bytes/token. Một request 1 triệu token giờ đây chỉ chiếm chưa tới 1GB VRAM cho riêng phần cache. Khai báo đúng chuẩn FP4 ở engine suy luận sẽ giúp hệ thống tiết kiệm VRAM, mở ra không gian để xử lý song song hàng chục phiên làm việc.
Bước chuyển mình về kiến trúc: Asynchronous Queue & EPD Disaggregation
Để một VPS gateway gánh vác lưu lượng lớn mà không làm nghẽn backend GPU, kiến trúc định tuyến cần được thiết kế lại, từ bỏ hoàn toàn các tư duy HTTP request/response đồng bộ lỗi thời.
Thay thế timeout bằng Asynchronous Task Queue
Trong quá khứ, khi đối mặt với các request phân tích hàng chục nghìn token, developer thường chọn cách nới lỏng proxy_read_timeout trên Nginx lên 1800s (30 phút). Đây là một phương pháp xử lý tạm thời tốn nhiều tài nguyên. Việc bắt hạ tầng web mở kết nối và chờ đợi sẽ khóa các web worker, gây cạn kiệt connection pool và mở ra lỗ hổng cho các cuộc tấn công từ chối dịch vụ (DoS).
Giải pháp mang tính bền vững là triển khai hàng đợi tác vụ bất đồng bộ (Asynchronous Task Queue) sử dụng Redis, RabbitMQ hoặc AWS SQS kết hợp với luồng Server-Sent Events (SSE). Thay vì bắt VPS phải chờ đợi thụ động cho đến khi backend trả kết quả, Kỹ sư hệ thống cần cấu hình phân tải API để xử lý nghẽn cổ chai thông qua hàng đợi bất đồng bộ.
- Client gửi request 1M token tới API Gateway (VPS).
- Gateway đóng gói request đưa vào Queue và lập tức trả về cho client mã HTTP
202 Accepted kèm theo một job_id. Kết nối HTTP ban đầu được đóng lại, giải phóng web worker.
- Client sử dụng
job_id để mở một luồng SSE chuyên biệt, chờ nhận token truyền phát một chiều theo thời gian thực. Cơ cấu này biến VPS thành một bộ phận điều phối vững chắc.
Phân rã EPD (Encoder-Prefill-Decode): Chìa khóa mở rộng độc lập
Điểm đặc biệt cần nhấn mạnh: Queue không đẩy tác vụ xuống một GPU worker nguyên khối (monolithic worker). Kiến trúc Causal Encoder-Decoder (CED) của V4.1 được thiết kế chuyên biệt cho việc phân tách phần cứng thông qua mô hình Encoder-Prefill-Decode (EPD) disaggregation.
Hệ thống Queue sẽ điều phối job qua hai cụm worker EPD tách biệt:
- Cụm Prefill (Chạy 8B tham số): Tập trung toàn bộ năng lực Tensor Core để xử lý 1 triệu token đầu vào, tạo ra KV cache.
- Chuyển giao trạng thái (KV Transfer): Trạng thái KV cache vừa được sinh ra sẽ được chuyển qua đường truyền tốc độ cao (RDMA/InfiniBand) sang cụm Decode.
- Cụm Decode (Chạy 16B tham số): Chuyên biệt hóa cho việc sinh token. Việc tách rời cụm này giúp luồng sinh token tự hồi quy hoạt động liên tục, mượt mà mà không bị các chuỗi Prefill nặng nề của user khác cản trở (overlapping execution).
Sự phân rã EPD cho phép Kỹ sư hệ thống scale riêng lẻ cụm Prefill nếu ứng dụng thiên về phân tích tài liệu (RAG), hoặc scale riêng cụm Decode nếu ứng dụng thiên về sinh văn bản dài.
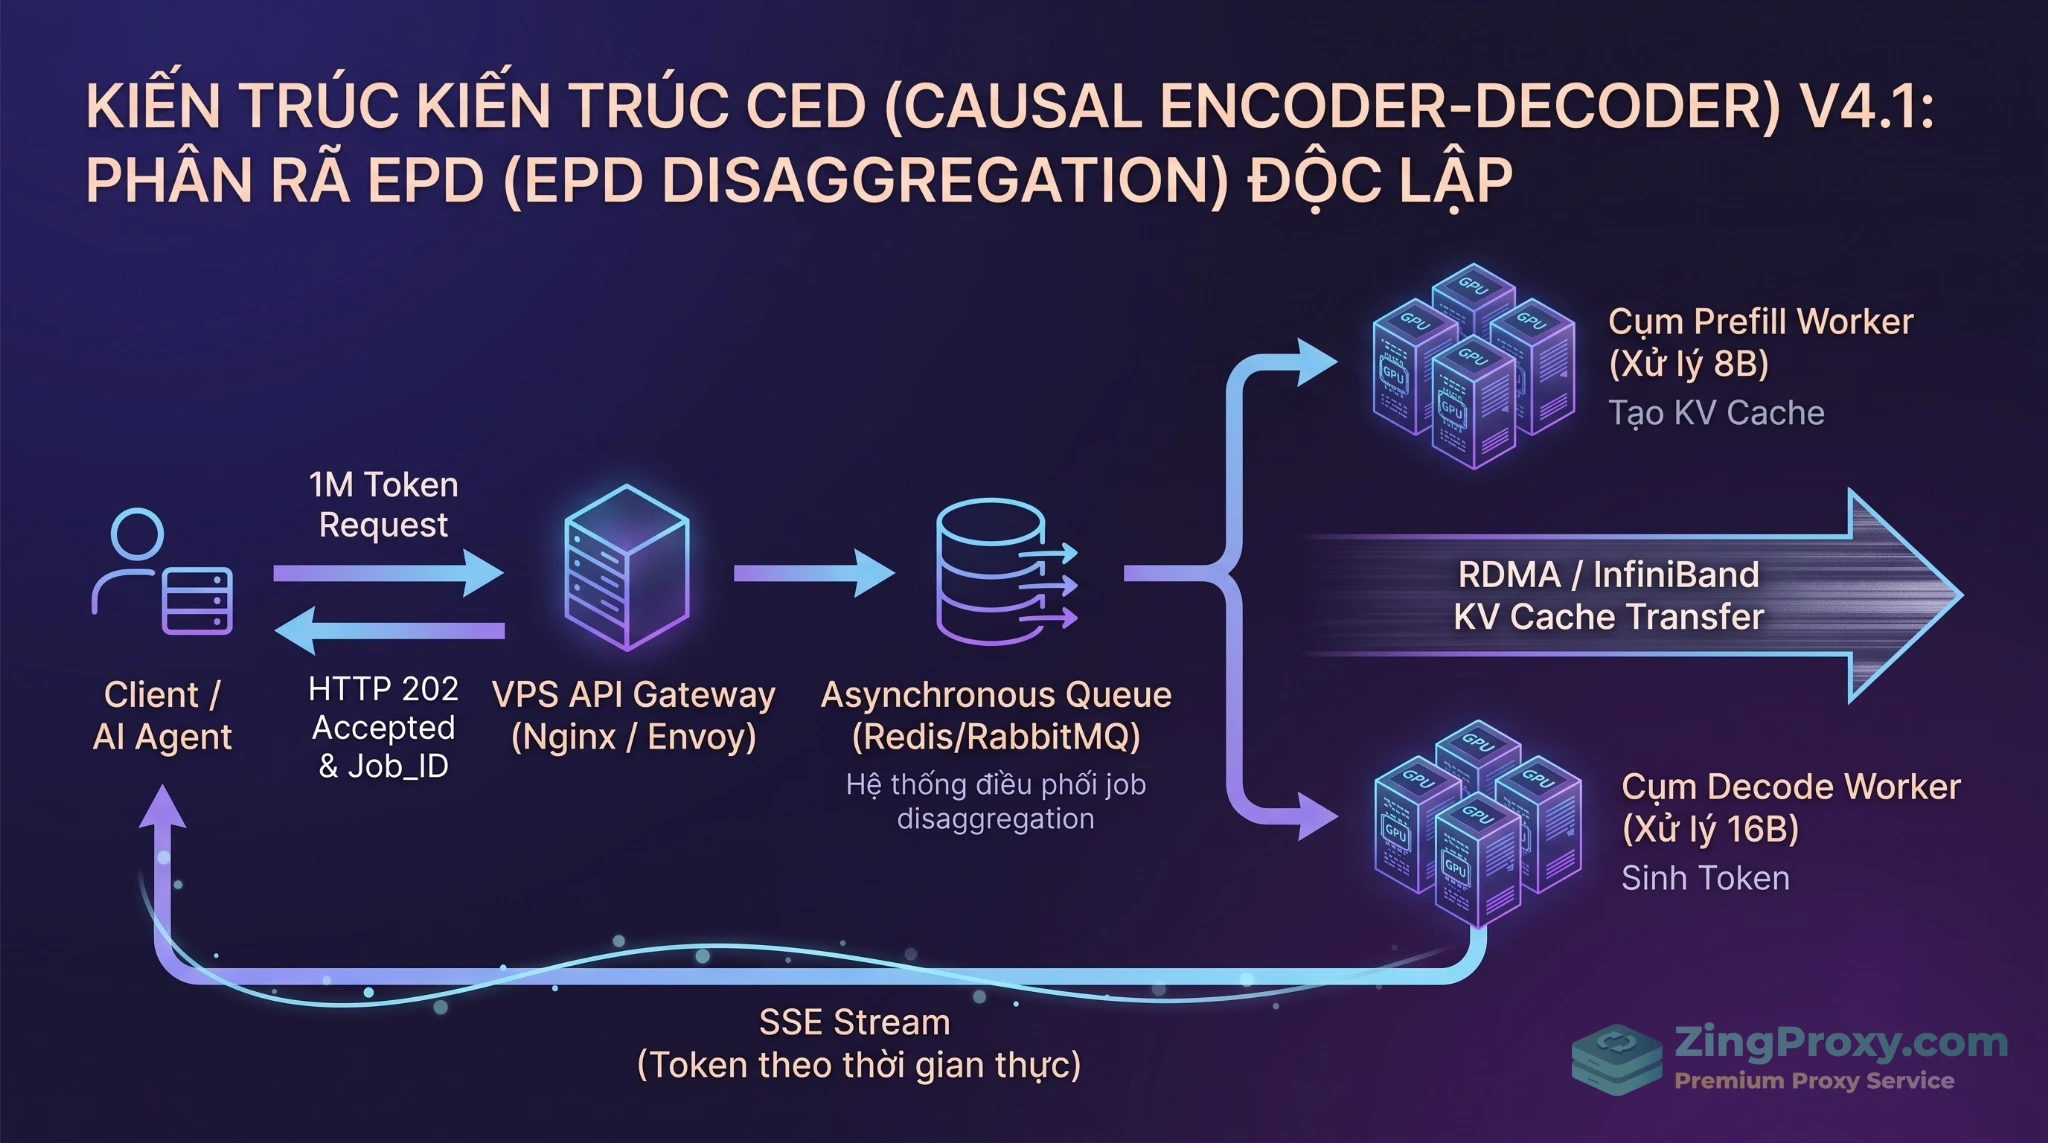
Phân tách quy trình Prefill và Decode qua hàng đợi bất đồng bộ giúp bảo vệ cụm GPU khỏi tình trạng quá tải request đột ngột.
Định tuyến KV-Aware & đột phá SWA Bounded Replay
Bên cạnh Queue, tầng Gateway cần tích hợp các kỹ thuật quản trị bộ nhớ đệm tinh vi để giảm tải cho phần cứng.
KV-Aware Routing: Định tuyến theo bộ đệm thực tế
Khi nhận một request từ hàng đợi, Router không sử dụng cơ chế Round-Robin ngẫu nhiên. Lớp KV-Aware Router sẽ bảo trì một hệ thống Cây Tiền Tố (Radix Cache Tree) để lập bản đồ bộ nhớ.
Khi một user yêu cầu phân tích một tài liệu dài, Router kiểm tra xem GPU Worker nào trong cụm Prefill đã từng xử lý tài liệu này và đang giữ KV cache của nó trên VRAM (Cache Hit). Việc định tuyến request về chính xác node đó giúp hệ thống bỏ qua toàn bộ công đoạn tính toán lại Prefill, rút ngắn TTFT đáng kể.
Cập nhật công nghệ: SWA Bounded Replay thay thế Prefix Caching truyền thống
Một trong những hạn chế của các mô hình LLM trước đây là việc lưu trữ bộ đệm dài hạn (Persistent Cache) tốn rất nhiều không gian ổ cứng (SSD). Các kiến trúc cũ sử dụng cờ Prefix Caching để lưu lại toàn bộ Sliding-Window Attention (SWA) KV cache nhằm tái sử dụng.
DeepSeek V4.1 giải quyết bài toán này bằng cơ chế hiện đại: SWA Bounded Replay. Thay vì phải đổ toàn bộ dữ liệu SWA KV cache lên ổ cứng, hệ thống chỉ cần tái tạo lại (replay) một số lượng token giới hạn ($n_{win}$ tokens) để thiết lập lại trạng thái ngữ cảnh.
Kỹ thuật Bounded Replay giúp giảm không gian lưu trữ KV cache vĩnh viễn xuống chỉ còn khoảng 1/8 so với phiên bản V4 trước đó. Điều này mang lại giá trị thực tiễn cho các Kỹ sư hệ thống: bạn có thể phục vụ hàng chục ngàn phiên làm việc của người dùng với chi phí lưu trữ hạ tầng tối ưu, trong khi tốc độ khôi phục ngữ cảnh (context resumption) vẫn được đảm bảo độ trễ thấp.
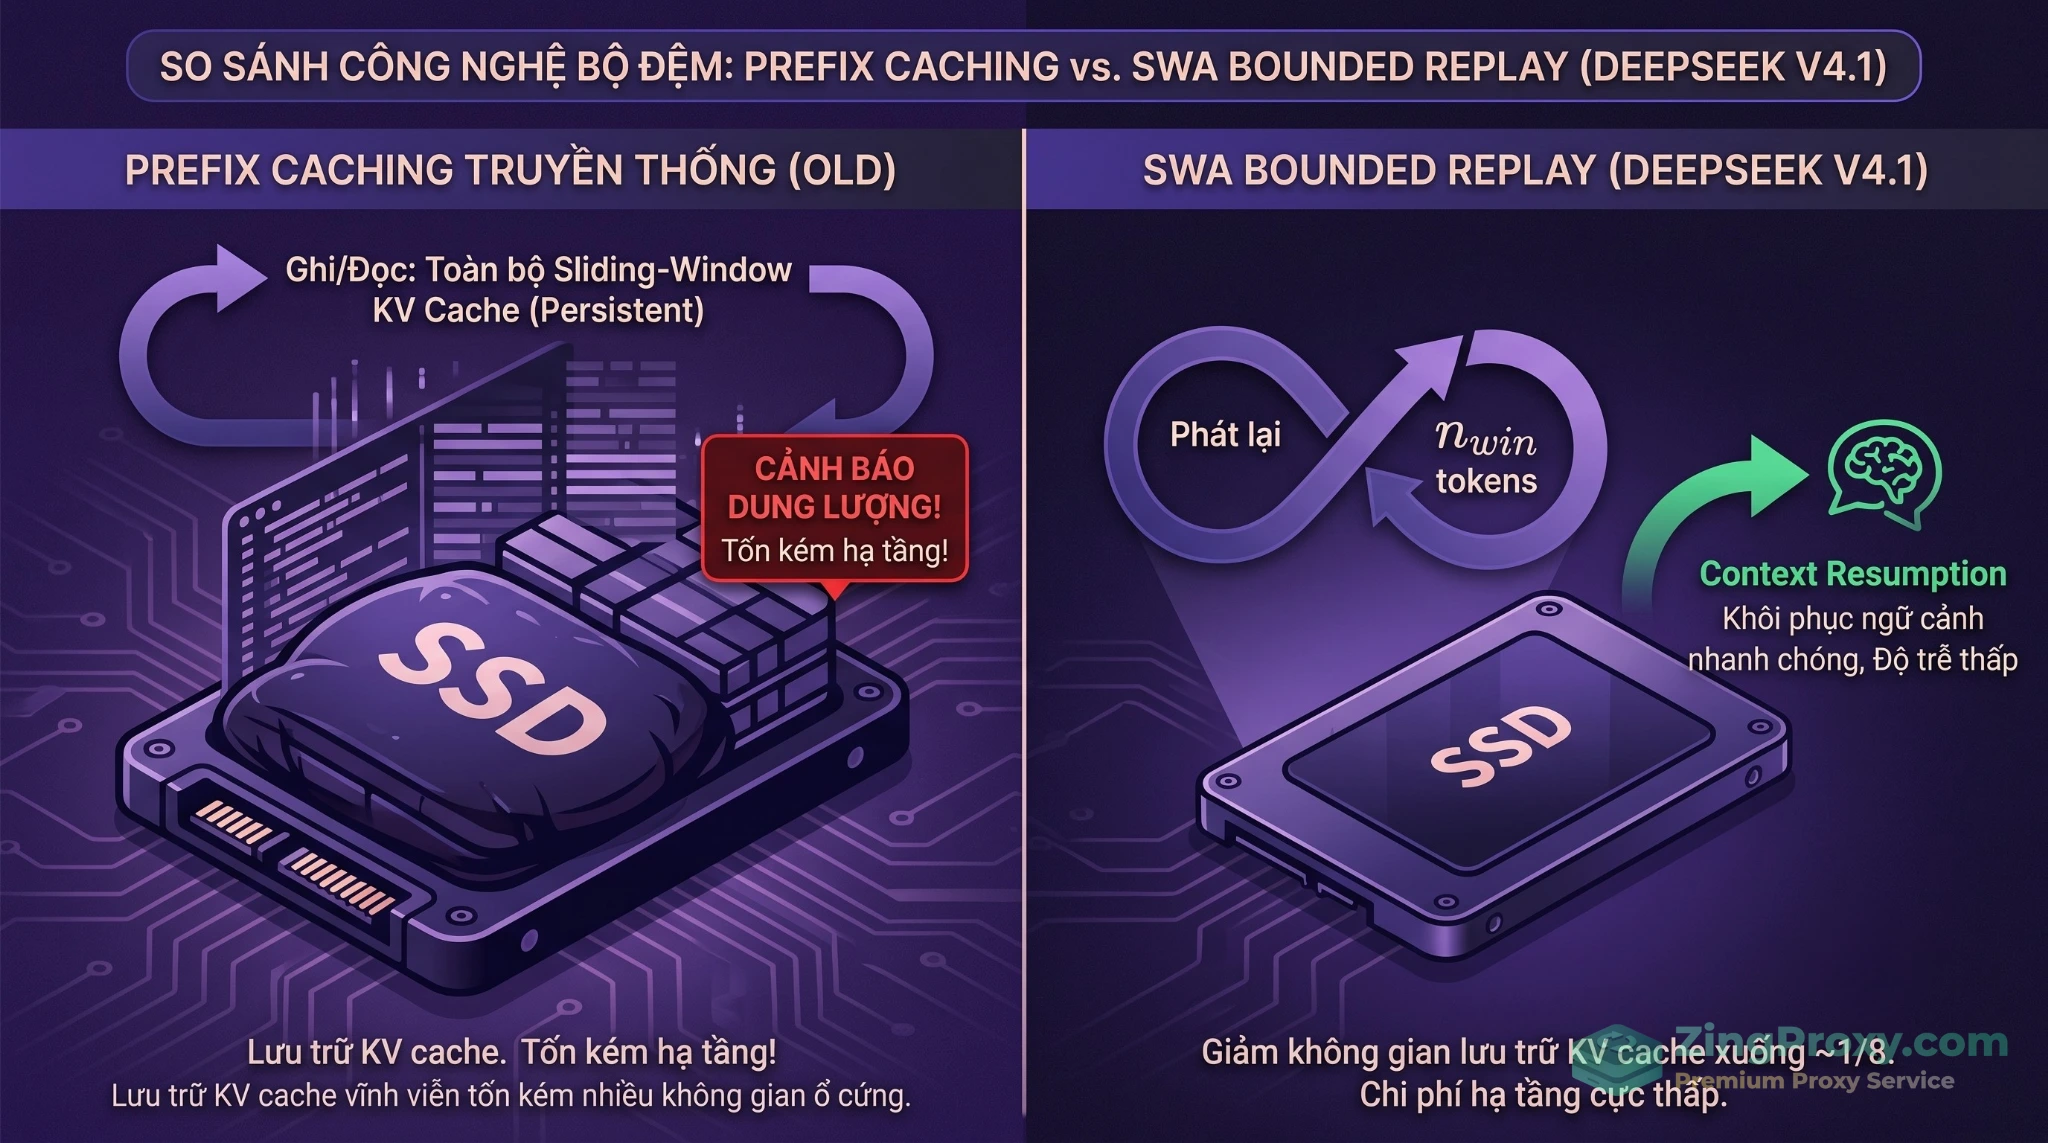
Cơ chế SWA Bounded Replay giảm thiểu đáng kể không gian lưu trữ KV cache tĩnh trên phần cứng so với các phương pháp trước đây.
Thực chiến cấu hình reverse proxy và engine suy luận
Lý thuyết kiến trúc cần được hiện thực hóa bằng mã lệnh thực chiến. Dưới đây là cách tinh chỉnh các thành phần thiết yếu trong hệ thống.
Cấu hình Nginx bảo vệ luồng SSE và tắt buffering
Ở Lớp VPS Gateway, Nginx tiếp nhận luồng SSE từ backend để trả về cho người dùng. Bạn cần áp dụng các kỹ thuật cấu hình Reverse Proxy Nginx nâng cao với một tệp cấu hình chuyên biệt (/etc/nginx/conf.d/llm_gateway.conf) để bảo vệ luồng stream:
upstream api_gateway {
    # Ưu tiên node có ít kết nối đang xử lý
    least_conn;
    server 10.0.1.11:8000 max_fails=3 fail_timeout=15s;
    server 10.0.1.12:8000 max_fails=3 fail_timeout=15s;

    # Giữ kết nối TCP mở để giảm overhead
    keepalive 64;
}

server {
    listen 443 ssl http2;
    server_name api.yourdomain.com;

    # Cho phép Payload chứa 1M token và dữ liệu đính kèm
    client_max_body_size 64m;
    client_body_timeout 60s;

    location /v1/chat/stream {
        proxy_pass http://api_gateway;

        # Bắt buộc ép HTTP/1.1 và duy trì kết nối
        proxy_http_version 1.1;
        proxy_set_header Connection "";

        # Tắt bộ đệm bảo vệ luồng SSE Streaming
        proxy_buffering off;
        proxy_request_buffering off;
        proxy_cache off;
        add_header X-Accel-Buffering "no" always;

        # Tắt thuật toán Nagle, đẩy chunk về client ngay lập tức
        tcp_nodelay on;

        # Timeout cho luồng Stream (khoảng cách an toàn giữa 2 token liên tiếp)
        proxy_read_timeout 120s;
    }
}
Trong đoạn mã trên, proxy_read_timeout 120s là giới hạn đủ an toàn cho luồng SSE. Khoảng thời gian này chỉ đo đếm độ trễ giữa 2 token liên tiếp được trả ra từ cụm Decode, không phải tổng thời gian hoàn thành toàn bộ request 1M token. Nhiệm vụ chờ đợi đã được giao phó cho hệ thống Asynchronous Queue.
Quản trị rate-limit theo token budget
Nginx kiểm soát RPS (Requests Per Second) rất hiệu quả cho web tĩnh, nhưng áp dụng cho LLM lại có những rủi ro nghiêm trọng. Một ứng dụng tự động có thể gửi 5 request, mỗi request dài 200,000 token. Nếu dùng RPS, hệ thống vẫn cho lọt cả 5 request, dẫn đến cụm GPU quá tải vì OOM. Để áp dụng cơ chế giải quyết lỗi Rate Limit API bằng Token Bucket, bộ đếm ở tầng Edge sẽ đo lường trực tiếp số lượng Prompt Tokens.
Tại lớp API Gateway, bạn cần triển khai Token-Aware Rate Limiting. Bộ đếm ở tầng Edge sẽ đo lường trực tiếp số lượng Prompt Tokens kết hợp với Max Output Tokens dự toán. Nếu ngân sách (Token Budget) của một ứng dụng vượt quá giới hạn, hệ thống trả về mã 429 Too Many Requests ngay tại VPS mà không làm ảnh hưởng đến hiệu suất của GPU.
Cấu hình engine suy luận tối ưu phần cứng
Để cụm Worker khai thác hiệu quả sức mạnh phần cứng, việc khởi chạy backend (như SGLang hoặc vLLM bản cập nhật) cần đi kèm các tham số (flags) định hình bộ nhớ:
--kv-cache-dtype fp4: Khai báo định dạng nén FP4 KV caching. Đây là cờ mấu chốt để ép dung lượng bộ nhớ xuống mức 890 bytes/token.- Triển khai EPD Workers: Các engine suy luận hiện đại hỗ trợ khai báo mode hoạt động riêng biệt. Chạy cụm Prefill với cấu hình tối ưu GEMM và chạy cụm Decode riêng biệt để tận dụng thiết kế Causal Encoder-Decoder.
- Kích hoạt SWA Bounded Replay: Thay thế việc cấp phát dung lượng SSD lớn bằng cấu hình replay các token trong giới hạn $n_{win}$, giảm áp lực cho hệ thống lưu trữ tĩnh.
--enable-chunked-prefill: Chia nhỏ các prompt dung lượng lớn thành các block (ví dụ: 131,072 token) để tính toán xen kẽ, giúp cân bằng tải nội bộ.--max-model-len 1048576: Khai báo rõ ràng ngưỡng context giới hạn của hệ thống.
Giám sát (Observability) và tự động phục hồi hạ tầng
Một hệ thống phân tán phức tạp không thể vận hành hiệu quả nếu thiếu tầm nhìn. Việc xây dựng hệ thống giám sát Proxy Grafana & Prometheus chi tiết là yêu cầu bắt buộc để Kỹ sư vận hành tập trung theo dõi các chỉ số hoạt động quan trọng.
Bắt mạch hệ thống qua Grafana
Kỹ sư vận hành cần tập trung theo dõi các chỉ số cốt lõi được xuất ra từ /metrics của engine suy luận:
- Nhóm chỉ số độ trễ: Theo dõi
e2e_request_latency_seconds với phân vị P50, P90, P99. Nếu đường biểu diễn P99 tăng đột biến, hệ thống đang xuất hiện hiện tượng thắt cổ chai ở cụm Prefill hoặc độ trễ mạng RDMA khi transfer KV.
- Nhóm chỉ số bộ nhớ:
gpu_cache_usage_factor đóng vai trò như bộ chứa tài nguyên. Khi chỉ số này tiệm cận mức 0.95 (tức 95% VRAM dành cho KV cache đã đầy), nguy cơ tráo đổi bộ nhớ hoặc OOM đang đến gần.
- Trạng thái hàng đợi: Theo dõi chiều dài của Redis/RabbitMQ queue. Nếu queue phình to mà lượng request hoàn thành không tăng, cụm GPU worker đang gặp sự cố nghẽn mạng nội bộ hoặc kẹt tài nguyên.
Tự động loại bỏ node lỗi (Automated Eviction)
Hạ tầng cấp doanh nghiệp cần khả năng tự chữa lành (self-healing). Thông qua Prometheus Alertmanager, Kỹ sư hệ thống có thể thiết lập bộ quy tắc: Nếu gpu_cache_usage_factor duy trì mức > 0.95 trong 30 giây, hoặc API Gateway ghi nhận lỗi xử lý job từ queue liên tiếp, hệ thống sẽ gửi tín hiệu cảnh báo mức độ Critical.
Lúc này, endpoint /health của node đó sẽ báo lỗi 503 Service Unavailable. Các luồng định tuyến từ VPS sẽ lập tức ngừng chuyển job vào node đang gặp sự cố. Node sự cố sẽ được phép xử lý nốt các tác vụ đang chạy dở (drain phase) trước khi tự động khởi động lại dịch vụ để dọn dẹp VRAM, bảo vệ toàn bộ cụm khỏi hiệu ứng sụp đổ dây chuyền (cascading failure).
Câu hỏi thường gặp (FAQ)
1. Tại sao không thể dùng VPS CPU thông thường để chạy DeepSeek V4.1?
Mô hình yêu cầu hơn 600GB VRAM chỉ để khởi chạy trọng số và cấp phát bộ đệm. VPS CPU truyền thống vừa thiếu hụt dung lượng RAM, vừa không có băng thông bộ nhớ HBM tốc độ cao (Memory Bandwidth), dẫn đến hệ thống treo ngay lập tức khi xử lý ngữ cảnh dài. Bạn bắt buộc phải dùng Multi-GPU Cloud VPS.
2. EPD Disaggregation giải quyết vấn đề gì trong kiến trúc LLM?
EPD (Encoder-Prefill-Decode) chia tách cụm máy chủ thành hai phần độc lập: cụm chuyên xử lý đầu vào (Prefill) và cụm chuyên sinh token (Decode). Việc này giúp gỡ nút thắt cổ chai, tránh tình trạng tính toán ma trận đầu vào làm đóng băng các luồng đang sinh văn bản của người dùng khác.
3. SWA Bounded Replay khác gì với Prefix Caching bản cũ?
SWA Bounded Replay tiết kiệm không gian lưu trữ tĩnh trên SSD. Thay vì lưu trữ toàn bộ dữ liệu ngữ cảnh (Persistent Cache) vốn tốn kém, công nghệ này chỉ giữ lại một cửa sổ token giới hạn ($n_{win}$) và tái tạo lại chúng để khôi phục trạng thái, giảm áp lực lưu trữ xuống còn khoảng 1/8.
4. Làm sao để khắc phục dứt điểm lỗi 504 Gateway Timeout khi dùng Nginx?
Việc tăng proxy_read_timeout chỉ là cách giải quyết tạm thời tốn tài nguyên. Giải pháp triệt để là triển khai Asynchronous Task Queue (như Redis/RabbitMQ). Nginx chỉ việc nhận request, chuyển vào Queue, đóng kết nối HTTP ban đầu và trả luồng dữ liệu cho client qua Server-Sent Events (SSE).
5. Một request 1 triệu token tiêu tốn bao nhiêu VRAM thực tế?
Nhờ sự kết hợp của kiến trúc Compressed Sparse Attention 2 (CSA2) và chuẩn nén FP4 KV Caching, 1 triệu token ngữ cảnh hiện tại được ép xuống chỉ chiếm khoảng 890MB VRAM. Tuy nhiên, bạn vẫn cần tính toán cộng dồn con số này với dung lượng của trọng số mô hình gốc (khoảng 510GB).
Kết luận
Triển khai một VPS chạy DeepSeek V4.1 quy mô lớn để giải quyết mượt mà context 1 triệu token đòi hỏi yêu cầu cao về thiết kế hệ thống phân tán. Việc thay thế timeout truyền thống bằng Asynchronous Queue, áp dụng định tuyến KV-Aware, phân rã kiến trúc EPD Disaggregation và tối ưu bộ đệm với FP4, SWA Bounded Replay chính là chìa khóa. Nắm vững những kỹ thuật nền tảng này, developer và đội ngũ DevOps hoàn toàn có thể làm chủ các luồng dữ liệu AI agent quy mô lớn một cách trơn tru, ổn định và chuyên nghiệp.
Tài liệu tham khảo