Khi hệ thống tự động hóa của bạn bắt đầu scale từ một vài script thử nghiệm lên hàng chục, hàng trăm luồng worker chạy song song, màn hình console thường bắt đầu xuất hiện một nỗi đau quen thuộc: các dòng log đỏ rực báo lỗi HTTP 429 Too Many Requests. Workflow bị gãy nhịp, data pipeline bị drop, và các agent rơi vào trạng thái tê liệt.
Đứng trước cảnh tượng này, phản xạ của nhiều developer là lập tức thuê một dàn proxy, ném vào hệ thống với hy vọng việc xoay vòng địa chỉ IP sẽ giúp lách qua khe cửa hẹp của API. Thế nhưng, sau khi tốn một khoản chi phí hạ tầng không nhỏ, lỗi 429 vẫn ngoan cố xuất hiện. Nguyên nhân gốc rễ là do chúng ta chưa bắt đúng bệnh, dẫn đến việc dùng sai thuốc. Việc thiết lập Proxy Pool cho AI Agent mang lại hiệu quả to lớn trong việc mở rộng quy mô (scale-out), nhưng nó đòi hỏi một tư duy cấu trúc hạ tầng mạng rành mạch.
Đã đến lúc chúng ta cần mổ xẻ rạch ròi giới hạn nào đến từ bộ não LLM, và giới hạn nào đến từ môi trường mạng bên ngoài. Bạn đã sẵn sàng tái cấu trúc lại luồng API của mình để xử lý hàng ngàn request đồng thời một cách mượt mà chưa?
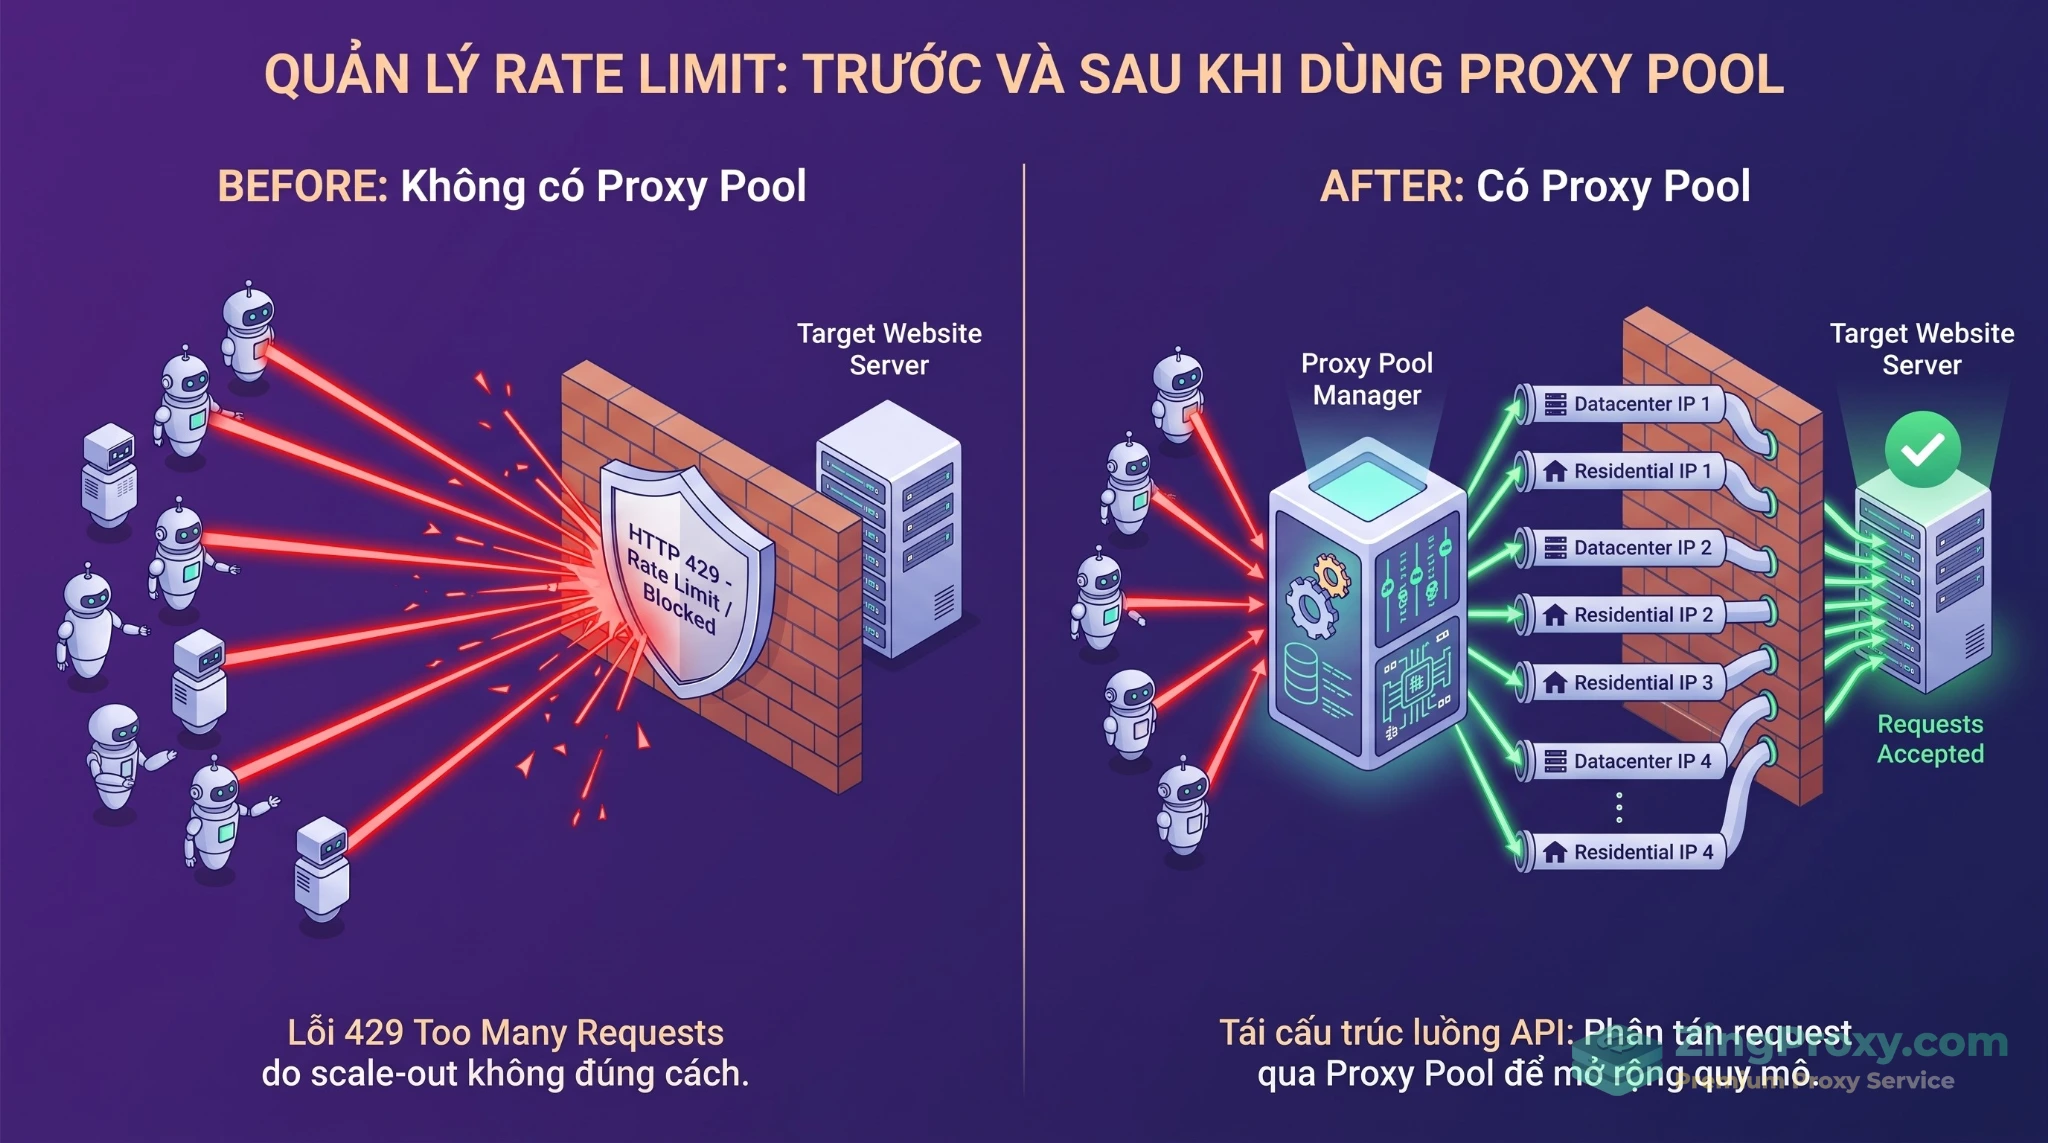
Kiến trúc tổng quan: So sánh luồng xử lý trước và sau khi tích hợp Proxy Pool cho dàn AI Agent.
Nỗi ám ảnh 429 Too Many Requests và sai lầm phổ biến về Rate-limit
Lỗi HTTP 429 từ OpenAI hay bất kỳ LLM Provider nào khác không đơn thuần xảy ra chỉ vì bạn gửi quá nhiều yêu cầu. Hệ thống máy chủ của họ tính toán tải trọng dựa trên một tổ hợp các chỉ số phức tạp. Khi hệ thống của bạn vô tình chạm đến bất kỳ ngưỡng nào trong bộ quy tắc này, API sẽ lập tức khóa van.
Bóc tách các chỉ số đo lường tần suất của OpenAI
Dựa trên tài liệu vận hành thực tế, rào cản tài nguyên được định hình qua các chiều dữ liệu sau:
- RPM (Requests Per Minute): Giới hạn số lượng yêu cầu HTTP tối đa được gửi đi trong 1 phút.
- TPM (Tokens Per Minute): Tổng số lượng token xử lý (bao gồm input và estimated output) trong vòng 60 giây. Cần lưu ý, mức tiêu thụ TPM cho mỗi request được tính toán dựa trên giá trị lớn hơn giữa tham số
max_tokens bạn thiết lập và số token hệ thống tự ước tính. Đặt max_tokens quá cao có thể khiến bạn cạn kiệt TPM từ sớm.
- RPD (Requests Per Day) & TPD (Tokens Per Day): Trần lưu lượng tổng trong chu kỳ 24 giờ.
- Batch API Limits: Hạn ngạch độc lập dành cho các tác vụ xử lý hàng loạt, đo lường bằng số lượng Queued Prompt Tokens (token nằm trong hàng chờ).
Ngoài ra, lỗi 429 còn có thể bị kích hoạt bởi các nguyên nhân như slow_down (khi lưu lượng request tăng vọt đột ngột, quá nhanh so với biểu đồ tăng trưởng an toàn) hoặc credit_balance_exhausted (tài khoản cạn kiệt số dư trả trước).
Sai lầm kinh điển: Dùng Proxy để tránh Rate-limit của LLM
Một lầm tưởng rất phổ biến trong cộng đồng lập trình là tin rằng việc sử dụng Proxy để che giấu hoặc thay đổi IP liên tục sẽ giúp vượt qua luật rate-limit của OpenAI. Trong thực tế kiến trúc API hiện đại, cách làm này hoàn toàn vô nghĩa.
Hệ thống kiểm soát tốc độ của OpenAI được thiết kế dựa trên cơ chế định danh Account-scoped (quản lý theo API Key, Organization ID, và Project ID), chứ không phải IP-scoped (quản lý theo địa chỉ IP nguồn). Bất kể bạn tự động hóa Proxy Rotation bằng Python qua hàng ngàn địa chỉ IP khác nhau, miễn là các request đó vẫn đính kèm chuỗi Authorization: Bearer <API_KEY> của bạn, máy chủ vẫn tính dồn tất cả vào chung một bộ đếm hạn ngạch. Việc phân tán IP qua Proxy không giúp nhân bản hay cơi nới giới hạn gọi LLM.
Vậy, Proxy thực sự phát huy hiệu quả ở khâu nào?
Phân định 2 mặt trận Rate-limit khi vận hành AI Agent
Một AI Agent tự động hóa hoàn chỉnh thường mang hai nhiệm vụ: (1) Suy luận thông qua bộ não LLM và (2) Tương tác, thu thập dữ liệu từ thế giới bên ngoài thông qua các công cụ (Custom Tools). Việc vận hành trơn tru đòi hỏi chúng ta phải xử lý rate-limit theo hai hướng hoàn toàn riêng biệt.
Mặt trận 1: Agent gọi LLM (OpenAI, Anthropic API)
- Cơ chế giới hạn: Quản trị qua định danh tài khoản và API Key.
- Giải pháp xử lý: Ở mặt trận này, Proxy xoay vòng không có tác dụng. Bạn cần can thiệp ở tầng ứng dụng (Application Layer):
- Concurrency Control: Sử dụng các kỹ thuật như Semaphore để khống chế số lượng luồng (in-flight requests) gọi lên server cùng một thời điểm.
- Thuật toán Backoff: Ứng dụng cơ chế thử lại (retry) với độ trễ tăng dần kết hợp nhiễu ngẫu nhiên.
- Tối ưu cấu trúc tài khoản: Nâng hạng (Tier) tài khoản bằng cách tăng hạn mức thanh toán trả trước.
- Khai thác Batch API: Dịch chuyển các tác vụ không yêu cầu thời gian thực (real-time) sang Batch API để hưởng lợi từ hạn ngạch riêng biệt và chi phí rẻ hơn.
- Để khống chế số lượng luồng (in-flight requests) gọi lên server cùng một thời điểm, các kỹ sư hệ thống thường áp dụng phương pháp giải quyết lỗi Rate Limit API bằng combo Token Bucket và Proxy Pool nhằm điều tiết băng thông hiệu quả.
Mặt trận 2: Agent gọi Custom Tool (Web/API bên thứ 3)
- Cơ chế giới hạn: Quản trị qua lớp hạ tầng mạng (địa chỉ IP, TLS Fingerprint, ASN danh tiếng mạng).
- Bản chất vấn đề: Khi Agent sử dụng các framework tự động hóa để thu thập dữ liệu từ các website đích (thương mại điện tử, mạng xã hội, máy chủ tìm kiếm), các hệ thống Anti-bot như Cloudflare, Akamai hay DataDome sẽ lập tức phân tích IP nguồn. Nếu phát hiện hàng ngàn request xuất phát từ một IP tĩnh của VPS, chúng sẽ chặn IP hoặc yêu cầu xác thực CAPTCHA.
- Giải pháp xử lý: Đây chính là sân nhà của kiến trúc Proxy Pool cho AI Agent. Việc thiết lập một mạng lưới Egress Proxy giúp phân tán lưu lượng, giả lập môi trường mạng của người dùng đa khu vực và bảo vệ an toàn cho máy chủ gốc. Đặc biệt khi kết hợp với các framework điều khiển trình duyệt thế hệ mới dành riêng cho AI như Browser Use hay Stagehand, Proxy Pool giúp Agent tương tác với các trang web phức tạp một cách trơn tru.
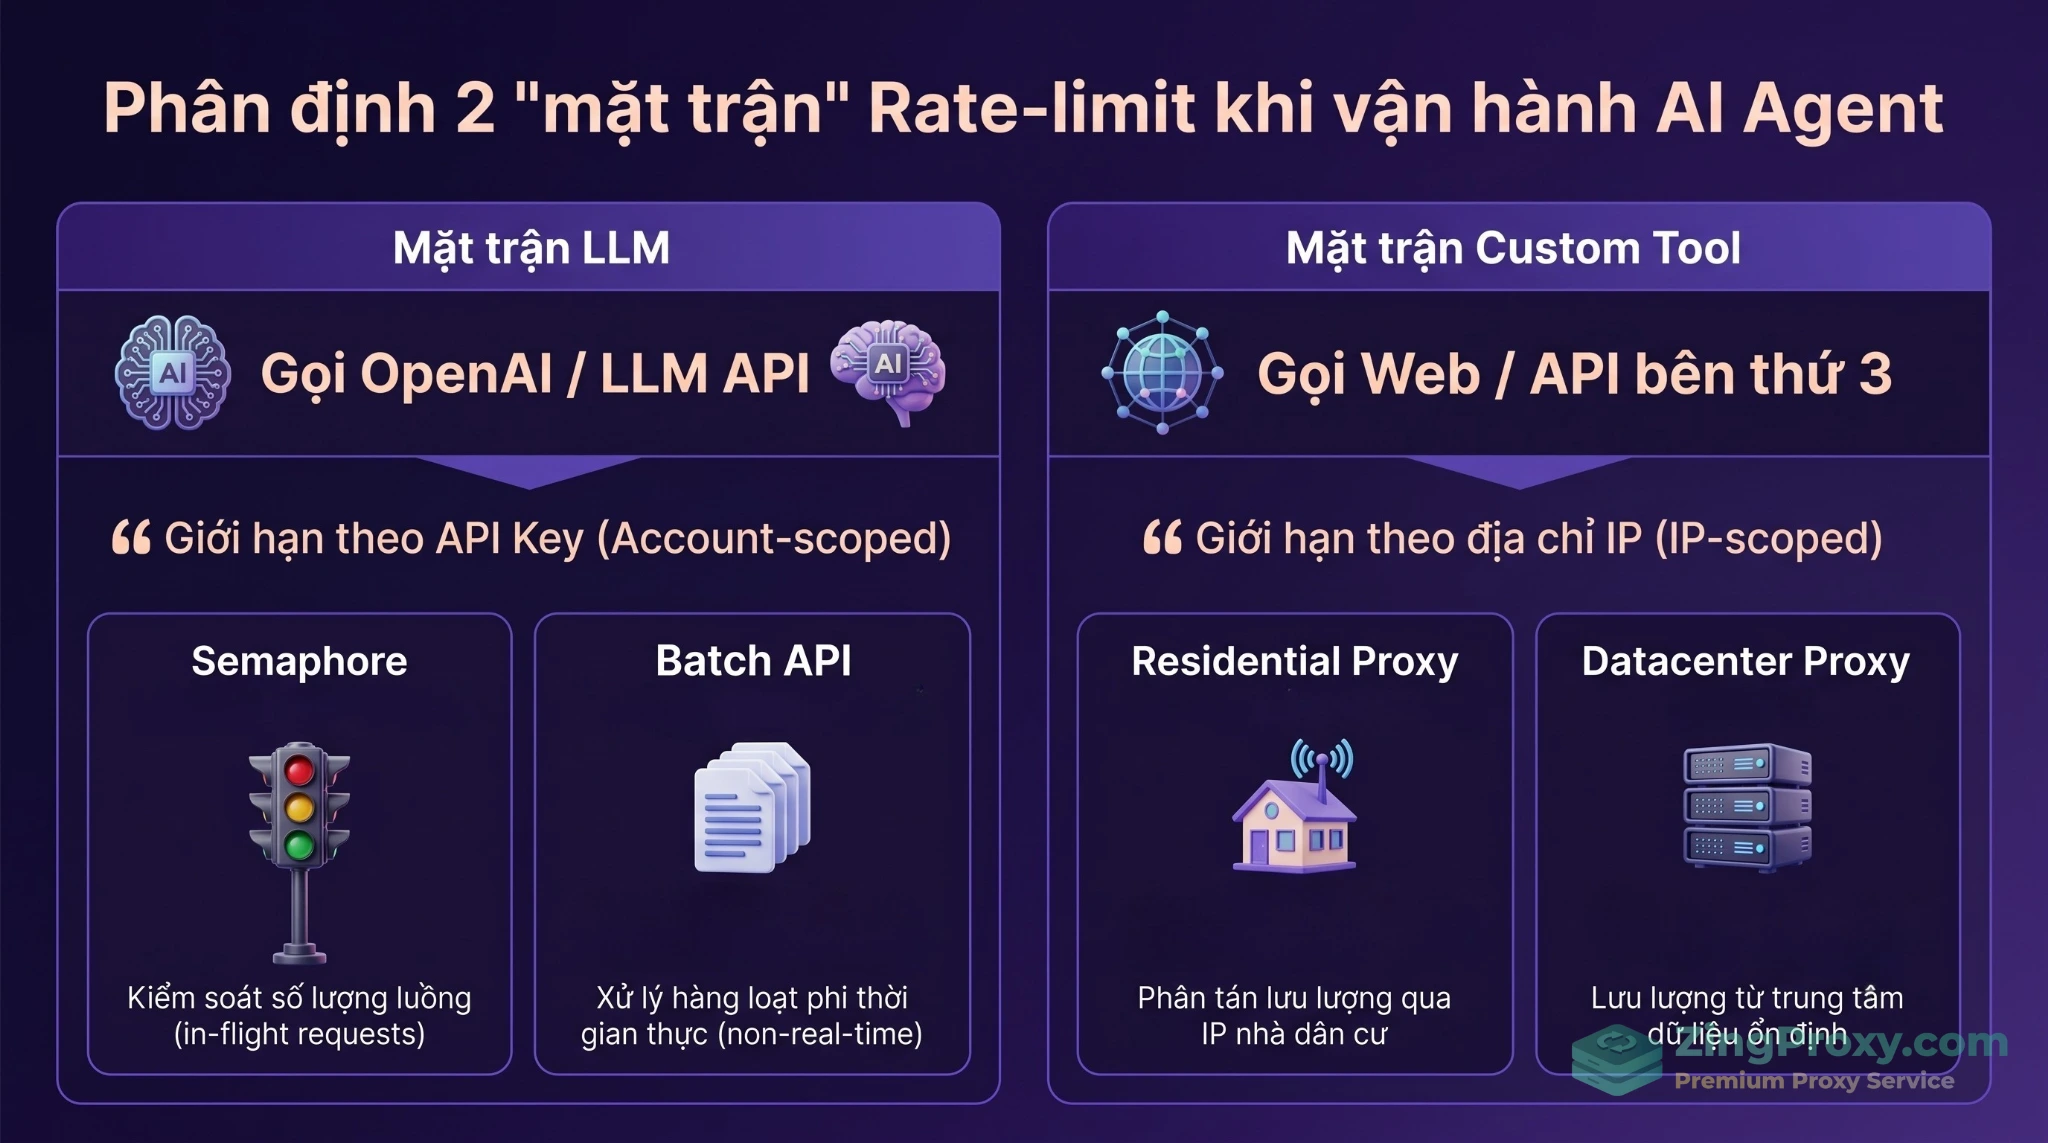
Hai mặt trận Rate-limit: Giới hạn từ LLM Provider (Account-scoped) và giới hạn từ hệ thống mạng bên ngoài (IP-scoped).
Kiến trúc thiết lập Proxy Pool cho AI Agent chuẩn DevOps
Để hệ thống hoạt động ổn định ở Mặt trận 2, việc cấu trúc một Proxy Pool yêu cầu bạn phải chọn đúng loại hạ tầng mạng và định hình rõ chiến lược luân chuyển IP.
Phân bổ tài nguyên: Datacenter Proxy vs Residential Proxy
Sự khác biệt về nguồn gốc IP quyết định trực tiếp đến tỷ lệ thành công của Agent khi tương tác với các hệ thống phòng thủ. Nếu bạn còn phân vân trong việc lựa chọn Proxy dân cư, datacenter, proxy di động loại nào phù hợp với bạn, hãy tham khảo bảng so sánh nhanh dưới đây:
| Tiêu chí |
Datacenter Proxy |
Residential Proxy |
| Nguồn hạ tầng |
IP từ các máy chủ đám mây (AWS, GCP, Hetzner, DigitalOcean) |
IP do nhà mạng (ISP) cấp cho các thiết bị hộ gia đình thực |
| Độ uy tín (Reputation) |
Trung bình đến thấp (dễ bị hệ thống Anti-bot nhận diện là luồng máy chủ) |
Rất cao (khó phân biệt với người dùng internet thông thường) |
| Hiệu năng & độ trễ |
Băng thông lớn, tốc độ phản hồi tính bằng mili-giây |
Phụ thuộc tốc độ đường truyền dân sự, độ trễ biến động hơn |
| Khả năng bypass Anti-bot |
Phù hợp mục tiêu ít bảo mật, trang web tĩnh, API nội bộ (Soft targets) |
Hiệu quả cao khi vượt các tường lửa phức tạp, e-commerce, SERP |
| Mô hình chi phí |
Tối ưu chi phí (thường tính giá cố định theo số lượng IP/tháng) |
Chi phí cao hơn (thường tính tiền theo dung lượng băng thông $/GB) |
Chiến lược Hybrid Tiering (phân tầng linh hoạt):
Để cân bằng giữa tỷ lệ thành công và bài toán chi phí, mô hình chuẩn DevOps thường áp dụng cơ chế chuyển đổi dự phòng (Fallback). Hệ thống sẽ định tuyến các request thu thập dữ liệu cơ bản qua Datacenter Proxy trước để tận dụng tốc độ và cước phí rẻ. Chỉ khi hệ thống ghi nhận các mã lỗi như 403 Forbidden, 429 Too Many Requests từ trang đích, hoặc gặp CAPTCHA, request đó mới được luân chuyển (fallback) sang dải mạng Residential Proxy để xử lý dứt điểm.
Chiến lược luân chuyển (Rotation): Round-Robin vs Sticky Session
Tùy thuộc vào kịch bản vận hành mà bạn quyết định nên thiết lập Proxy xoay hay Proxy tĩnh:
- Thuật toán Round-Robin (xoay vòng từng request): Chiến lược này áp dụng cho các tác vụ Stateless (Không trạng thái) như thu thập giá sản phẩm, lấy tin tức hay tìm kiếm từ khóa. Mỗi request HTTP gửi đi sẽ được gán cho một địa chỉ IP hoàn toàn mới từ Pool. Việc phân tán lưu lượng liên tục giúp dàn Agent không tạo ra dấu vết traffic tăng đột biến tại bất kỳ IP cụ thể nào, giảm thiểu rủi ro bị chặn.
- Cấu hình Sticky Session (giữ nguyên IP): Đây là thiết lập bắt buộc cho các tác vụ Stateful (Có trạng thái). Khi Agent của bạn thao tác trên một workflow nhiều bước (ví dụ: Đăng nhập hệ thống -> Trích xuất báo cáo -> Cập nhật trạng thái), việc thay đổi IP giữa chừng sẽ làm đứt gãy kết nối TCP, vô hiệu hóa cấu trúc Cookie/Session và kích hoạt các cảnh báo bảo mật tài khoản (Account Takeover alert). Cấu hình Sticky Session cho phép khóa cứng một IP trong một khoảng thời gian (vài phút đến 24 giờ), đảm bảo quy trình đa bước hoàn tất trên cùng một định danh mạng.
Hướng dẫn kỹ thuật xử lý lỗi và duy trì kết nối mạng
Phần này đi sâu vào mã nguồn (Python Asyncio) để giải quyết hai vấn đề hạ tầng quan trọng: Kiểm soát luồng gọi API và xây dựng hệ thống quản lý Proxy vững chắc.
Cơ chế Concurrency Control và xử lý xung đột Retry (dành cho LLM API)
Khi lập trình bất đồng bộ, nếu bạn đẩy hàng trăm request vào asyncio.gather() mà không có cơ chế hãm, kết nối mạng sẽ bùng nổ và API trả về 429 ngay lập tức. Cấu trúc asyncio.Semaphore đóng vai trò như một trạm điều tiết: chỉ cho phép một số lượng request tối đa (in-flight requests) chạy qua cùng lúc.
Lưu ý rất quan trọng về xung đột Retry: Các phiên bản SDK chính thức của OpenAI hiện nay đã tích hợp sẵn cơ chế tự động thử lại (automatic retries). Nếu bạn muốn tự viết một cơ chế Exponential Backoff tùy chỉnh (ví dụ dùng thư viện tenacity), bạn BẮT BUỘC phải vô hiệu hóa tính năng retry mặc định của SDK bằng tham số max_retries=0. Nếu không, hệ thống sẽ rơi vào tình trạng thử lại chồng chéo, khiến số lượng request thực tế bùng phát ngoài tầm kiểm soát.
import asyncio
import os
from openai import AsyncOpenAI, RateLimitError, APIConnectionError
from tenacity import retry, stop_after_attempt, wait_random_exponential, retry_if_exception_type

# 1. Khởi tạo Client và TẮT retry mặc định của SDK để tránh xung đột
client = AsyncOpenAI(
    api_key=os.environ.get("OPENAI_API_KEY"),
    max_retries=0  # Quan trọng: Vô hiệu hóa built-in retry
)

# 2. Khống chế tối đa 10 luồng gọi đồng thời
MAX_CONCURRENT_REQUESTS = 10
semaphore = asyncio.Semaphore(MAX_CONCURRENT_REQUESTS)

# 3. Cấu hình thuật toán Full Jitter Backoff thông qua Tenacity
@retry(
    retry=retry_if_exception_type((RateLimitError, APIConnectionError)),
    wait=wait_random_exponential(min=1, max=60), # Chờ ngẫu nhiên từ 1s đến 60s
    stop=stop_after_attempt(5),
    reraise=True
)
async def fetch_llm_response(prompt: str):
    response = await client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": prompt}],
        max_tokens=150,
    )
    return response.choices[0].message.content

# 4. Context Manager điều tiết luồng
async def safe_agent_worker(prompt: str, task_id: int):
    async with semaphore: # Acquire slot
        print(f"[Task {task_id}] Đang xử lý qua LLM...")
        try:
            result = await fetch_llm_response(prompt)
            return result
        except Exception as e:
            print(f"[Task {task_id}] Lỗi thất bại hoàn toàn: {e}")
            return None
Thuật toán Full Jitter (cộng thêm nhiễu ngẫu nhiên vào thời gian chờ) trong đoạn code trên là tiêu chuẩn để ngăn chặn hiện tượng Thundering Herd (hiệu ứng bầy đàn), tình trạng hàng ngàn request cùng hết thời gian chờ và đồng loạt dội ngược vào máy chủ gây sập hệ thống lần hai.
Viết Proxy Pool Manager tích hợp Circuit Breaker chuẩn phân tán
Để điều hướng traffic đi ra ngoài (egress) qua Web/API thứ 3 hiệu quả, hệ thống quản lý Proxy cần triển khai mô hình Circuit Breaker (cầu dao tự động). Mô hình chuẩn trong kỹ nghệ phần mềm định nghĩa 3 trạng thái mạng lưới:
- CLOSED (Bình thường): Mạch đóng, Proxy hoạt động tốt, luồng request chạy qua trơn tru.
- OPEN (Ngắt kết nối / Cooldown): Khi phát hiện tỷ lệ lỗi (403, timeout) vượt ngưỡng
max_fails, hệ thống ngắt mạch. Proxy tạm thời bị rút khỏi Pool để tránh lãng phí request của Agent.
- HALF-OPEN (Thăm dò phục hồi): Sau thời gian Cooldown, mạch mở hé. Hệ thống cho phép một số request thăm dò (active probe) đi qua. Nếu thành công, trạng thái quay về
CLOSED. Nếu thất bại, mạch bật lại trạng thái OPEN với thời gian chờ lâu hơn.
Dưới đây là kiến trúc Python Async mô phỏng cơ chế này:
import asyncio
import time
import random
from enum import Enum
from dataclasses import dataclass
import httpx

class CircuitState(Enum):
    CLOSED = "CLOSED"       # Tương đương HEALTHY
    OPEN = "OPEN"           # Tương đương COOLDOWN/Lỗi
    HALF_OPEN = "HALF_OPEN" # Đang thăm dò phục hồi

@dataclass
class ProxyNode:
    url: str
    state: CircuitState = CircuitState.CLOSED
    fail_count: int = 0
    open_until: float = 0.0
    total_requests: int = 0

class CircuitBreakerProxyPool:
    def __init__(self, proxy_urls: list, max_fails: int = 3, base_cooldown: float = 30.0):
        self.nodes = [ProxyNode(url=url) for url in proxy_urls]
        self.max_fails = max_fails
        self.base_cooldown = base_cooldown
        self._lock = asyncio.Lock()

    async def get_proxy(self) -> str:
        """Định tuyến lấy Proxy đang ở trạng thái CLOSED (Hoạt động)"""
        async with self._lock:
            # 1. Kiểm tra các node OPEN đã đến hạn chuyển sang HALF-OPEN chưa
            now = time.time()
            for node in self.nodes:
                if node.state == CircuitState.OPEN and now >= node.open_until:
                    node.state = CircuitState.HALF_OPEN
                    print(f"[CIRCUIT HALF-OPEN] Đưa Proxy {node.url} vào diện thăm dò.")

            # 2. Lấy danh sách Proxy khả dụng (CLOSED hoặc HALF-OPEN)
            available_nodes = [
                n for n in self.nodes
                if n.state in (CircuitState.CLOSED, CircuitState.HALF_OPEN)
            ]

            if not available_nodes:
                raise RuntimeError("Hệ thống cảnh báo: Toàn bộ Circuit Breaker đang OPEN. Không có IP!")

            # Chọn Proxy có tải thấp nhất (Least-Used)
            selected = min(available_nodes, key=lambda n: n.total_requests)
            selected.total_requests += 1
            return selected.url

    async def report_result(self, proxy_url: str, success: bool, status_code: int = 0):
        """Đánh giá và chuyển đổi trạng thái Circuit Breaker sau khi request hoàn tất"""
        async with self._lock:
            node = next((n for n in self.nodes if n.url == proxy_url), None)
            if not node: return

            if success or (200 <= status_code < 400): # Nếu request thành công, reset mạch về CLOSED node.fail_count = 0 node.state = CircuitState.CLOSED return # Xử lý khi gặp lỗi (Timeout, 403, 429...) node.fail_count += 1 # Kích hoạt ngắt mạch (OPEN) if node.fail_count >= self.max_fails or node.state == CircuitState.HALF_OPEN:
                jitter = random.uniform(0.5, 2.0)
                # Thời gian chờ tăng theo cấp số nhân
                cooldown_time = (self.base_cooldown * (2 ** (node.fail_count - 1))) + jitter

                node.state = CircuitState.OPEN
                node.open_until = time.time() + cooldown_time
                print(f"[CIRCUIT OPEN] Proxy {node.url} ngắt mạch trong {cooldown_time:.1f}s.")
Bằng cách áp dụng mô hình Circuit Breaker, khi dàn Agent của bạn chạy trên các công cụ như Playwright, hoặc các framework AI-Native như Browser Use và Stagehand, việc tương tác với các giao diện DOM phức tạp sẽ không bị gián đoạn vô lý bởi các IP đã bị đánh cờ (flagged).
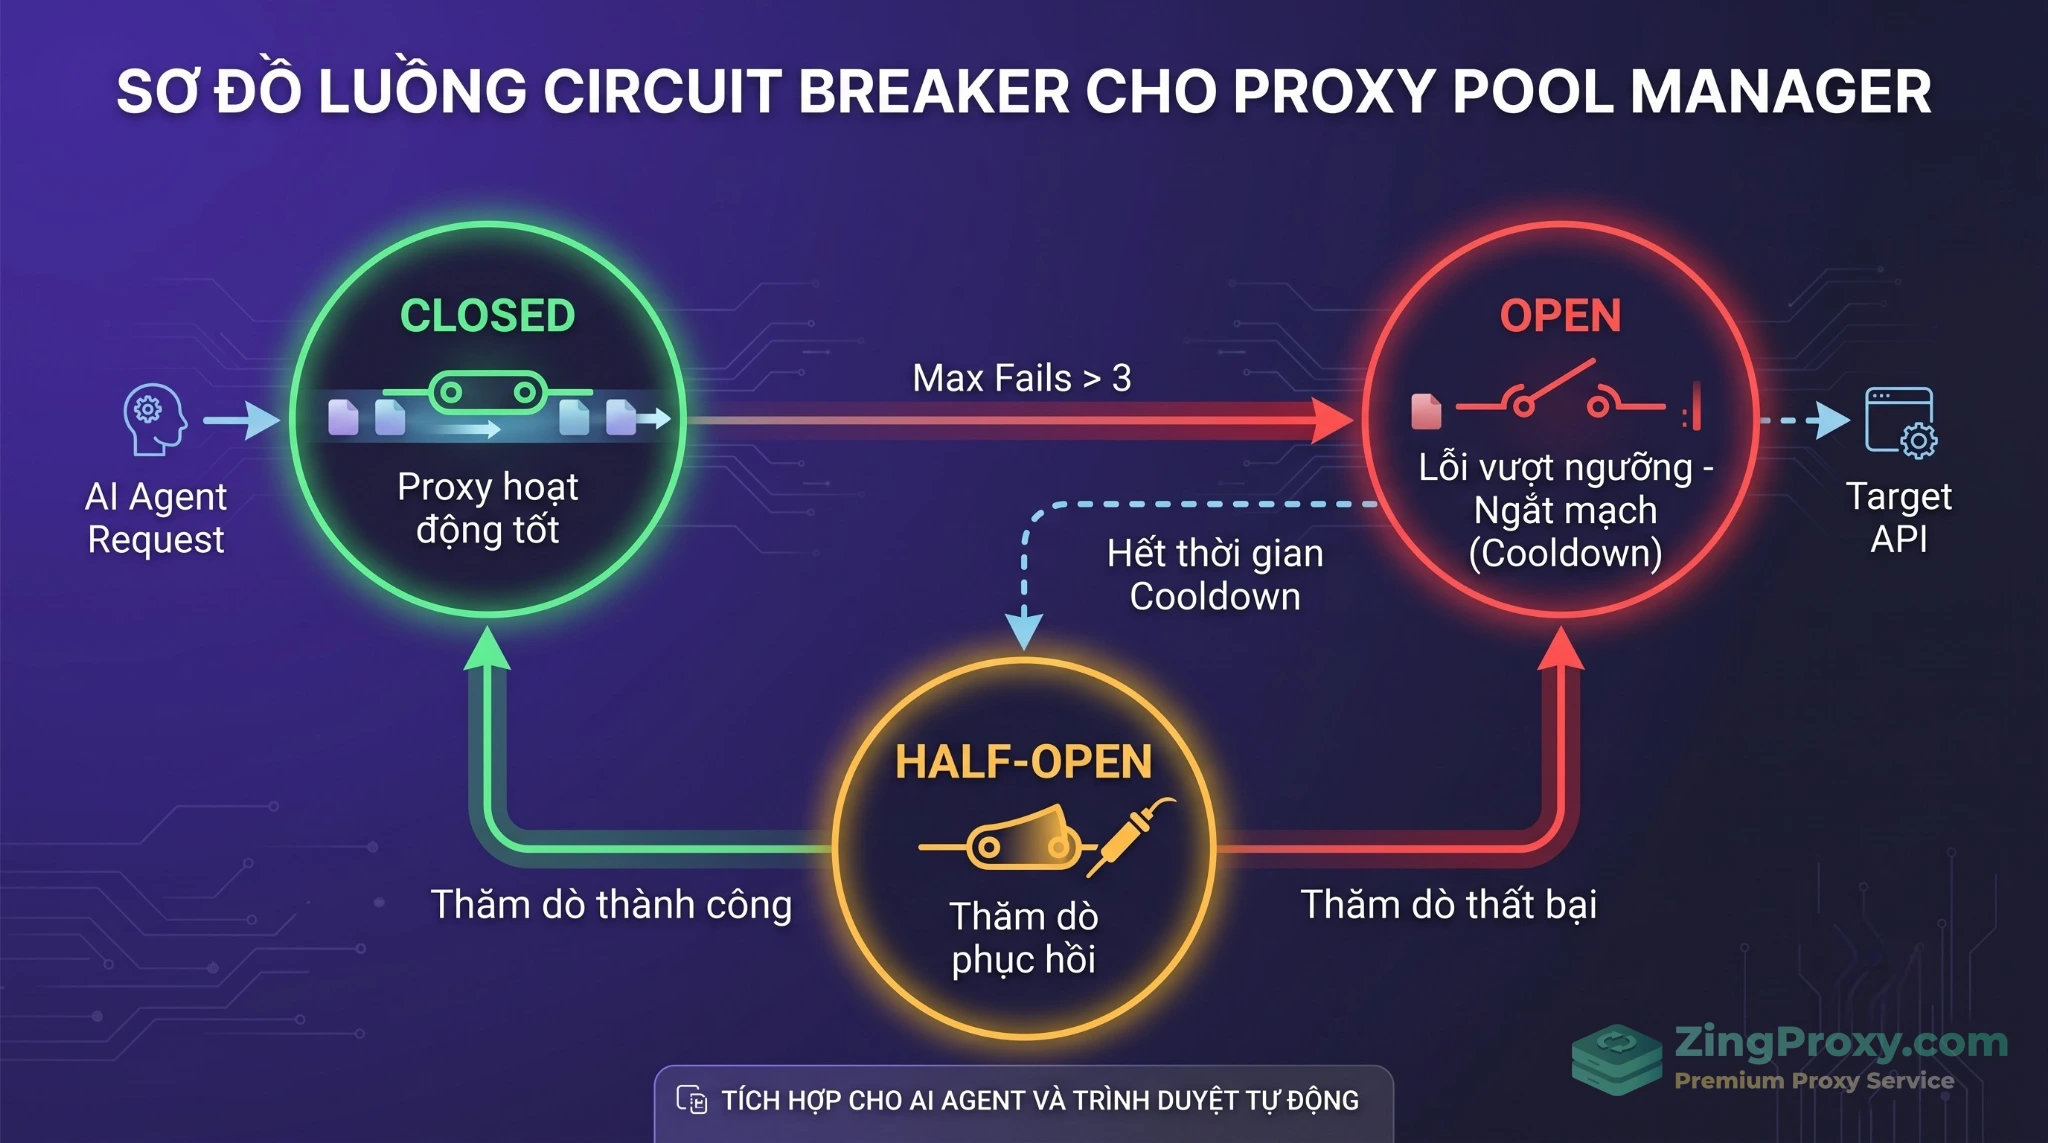
Cơ chế hoạt động của Circuit Breaker: Tự động phát hiện và cách ly các Proxy bị lỗi để bảo vệ luồng dữ liệu.
Tối ưu tài nguyên VPS để chạy đa luồng Agent hiệu quả
Quản trị tinh gọn ở tầng code phần mềm vẫn là chưa đủ nếu phần cứng hệ điều hành không được mở khóa giới hạn. Khi AI Agent kích hoạt hàng ngàn kết nối I/O qua lớp Proxy Pool, máy chủ VPS Linux mặc định có thể trở thành cổ chai bóp nghẹt hệ thống của bạn.
- Nâng giới hạn File Descriptor (ulimit): Trong kiến trúc Linux, mỗi kết nối mạng (socket) mở ra được hệ điều hành quản lý như một file. Mức mặc định
ulimit -n thường rất khiêm tốn ở con số 1024. Để tránh ứng dụng bị crash với lỗi Too many open files, bạn cần cấu hình lại /etc/security/limits.conf để mở rộng giới hạn này lên mức 65535.
- Khai thác Connection Pooling triệt để: Nếu Agent của bạn liên tục khởi tạo client HTTP mới cho mỗi thao tác, chi phí tài nguyên dành cho quá trình bắt tay bảo mật (TLS Handshake) sẽ vắt kiệt CPU. Hãy sử dụng tính năng Connection Pooling của thư viện mạng (ví dụ:
httpx.Limits(max_keepalive_connections=50)). Tính năng này duy trì các kênh kết nối TCP đang mở với Proxy Server, giúp các request tiếp theo được gửi đi gần như tức thì.
- Đồng thời, bạn nên tìm hiểu cách tối ưu routing edge VPS để giảm độ trễ (ping) và hao hụt gói tin khi Agent giao tiếp với các API quốc tế.
- Chiến lược phân bổ RAM hợp lý: Các tác vụ thiên về giao tiếp mạng (I/O bound) tiêu tốn khá ít CPU. Tuy nhiên, khi luồng LLM trả về các khối JSON dữ liệu khổng lồ và Agent cần giải mã (deserialize) chúng vào bộ nhớ, lượng RAM tiêu thụ sẽ tăng vọt. Đảm bảo cấu hình VPS có mức RAM phù hợp (thường từ 4GB – 8GB cho cụm worker tiêu chuẩn) và setup thêm Swap space để tạo vùng đệm an toàn.
Câu hỏi thường gặp (FAQ)
1. Dùng Proxy Pool có giúp tăng giới hạn RPM/TPM của OpenAI API không?
Không. Hệ thống rate-limit của OpenAI quản lý theo API Key và Organization, không đo lường theo địa chỉ IP. Proxy xoay vòng không làm tăng hạn ngạch gọi LLM.
2. Vậy khi nào AI Agent thực sự cần đến Proxy Pool?
Khi Agent của bạn chạy các Custom Tool để giao tiếp với thế giới bên ngoài (thu thập dữ liệu web, gọi API bên thứ ba). Lúc này Proxy Pool giúp vượt qua các tường lửa Anti-Bot chặn theo IP.
3. Nên chọn Datacenter Proxy hay Residential Proxy cho Agent?
Dùng Datacenter Proxy cho các website cấu trúc đơn giản, ít bảo mật để tối ưu chi phí. Luân chuyển sang Residential Proxy khi mục tiêu là các nền tảng có hệ thống bảo vệ phức tạp (E-commerce, SERP).
4. Nên xoay vòng IP (Round-Robin) hay giữ nguyên IP (Sticky Session)?
Chọn Round-Robin cho các tác vụ độc lập, không trạng thái (stateless) như thu thập giá sản phẩm. Chọn Sticky Session cho các luồng làm việc nhiều bước cần duy trì phiên đăng nhập và cookie (stateful).
5. Làm sao để xử lý lỗi 429 từ OpenAI hiệu quả?
Can thiệp ở tầng ứng dụng: Dùng Semaphore giới hạn số luồng (in-flight requests) chạy đồng thời, tắt retry mặc định của SDK và tự triển khai thuật toán Full Jitter Backoff.
6. Circuit Breaker trong quản lý Proxy Pool đóng vai trò gì?
Là cơ chế cầu dao tự động. Nó giúp hệ thống phát hiện các IP bị lỗi hoặc bị block, tạm thời cách ly chúng (Cooldown) để không làm lãng phí request và tự động đưa trở lại Pool khi IP phục hồi.
Kết luận
Việc xây dựng và quản trị một hệ thống Proxy Pool cho AI Agent là mắt xích hạ tầng quan trọng để hiện thực hóa các dự án tự động hóa quy mô lớn. Tuy nhiên, hiệu quả thực sự chỉ đến khi chúng ta phân tách rạch ròi bài toán: Giải quyết giới hạn của OpenAI bằng Semaphore, Full Jitter Backoff và Batch API; đồng thời giải quyết rào cản của môi trường mạng bên ngoài bằng chiến lược luân chuyển Datacenter Proxy/Residential Proxy thông qua mô hình Circuit Breaker tiêu chuẩn.
Với bộ khung kỹ thuật đã được tinh chỉnh đồng bộ từ Application Layer xuống đến cấu hình hệ điều hành VPS, hệ thống Agent của bạn giờ đây đã có một nền móng mạng lưới vững chãi. Bạn đã sẵn sàng triển khai kiến trúc này vào môi trường production và theo dõi hiệu suất xử lý bứt phá chưa?
Tài liệu tham khảo